0.有关CS106B#
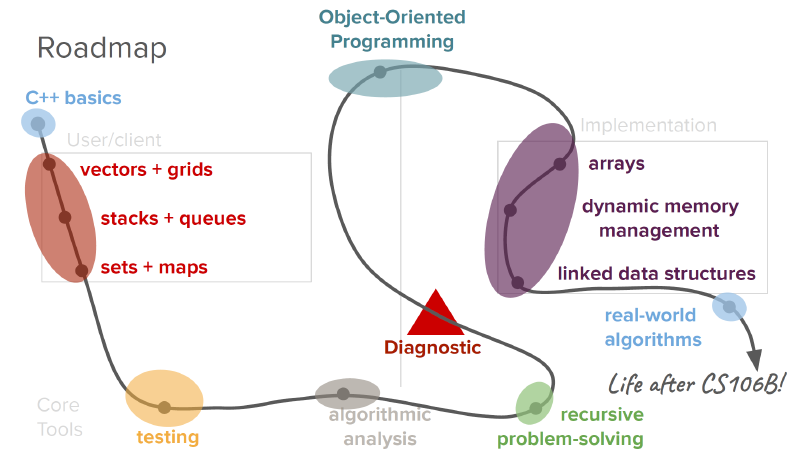
CS106B 将带您熟悉 C++ 编程语言,并介绍递归、算法分析和数据抽象等高级编程技巧,探索经典的数据结构和算法,并让您有机会运用这些工具解决复杂问题 (注意:它不会教你基本语法, 在这之前, 你需要一点的编程经验)
由于cs106B各个年份课程的开源程度不同,我们想要学习这门课程就需要结合不同年份的课程资源
Qt Qt6.11可用
1.什么是抽象#
从具体事物提取共同结构
抽象就是只告诉你这个东西能干什么,但不告诉你它到底是怎么干的, 抽象 = 隐藏怎么做,只暴露做什么 Design that hides the details of how something works while still allowing the user to access complex functionality
世间一切都是抽象 例如:你用美团点外卖,只要选菜、下单、付款就行,不需要懂服务器、数据库、网络协议等怎么工作的
2.在代码中使用抽象概念来构建数据#
ADT的定义(Abstract Data Type) ADT 是 “你想让一个东西表现成什么样,而不是它内部怎么实现” 常见的ADT: Vector,Queue,Stack
功能和实现的分离 实现于程序时,抽象数据类型只显现出其功能,并将实现加以隐藏 你只需关心它的功能,而不是如何实现,类似于可以不知道一些深奥的数学知识,但要会用它解决问题
4.值传递与引用传递#
什么是值传递?#
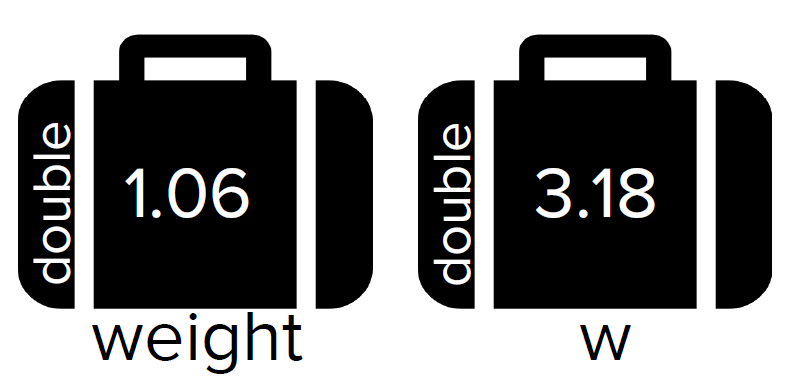
当一个参数传递给函数时,新变量会在内存中存储传递值的副本
void tripleWeight(double w) {
 w *= 3; // 重量三倍
}

int main() {
 double weight = 1.06;
 tripleWeight(weight);
 cout << weight << endl; //weigt仍是1.06
}
什么是引用传递?#
当向函数传递参数时,新变量会存储对传入值的引用,这允许您直接编辑原始值 在类型后面加上&
void tripleWeight(double& weight_ref) {
 weight_ref *= 3; // 重量三倍
}

int main() {
 double weight = 1.06;
 tripleWeight(weight);
 cout << weight << endl; //weight会变为3.18, 但我们通常不会这样编写代码……
}
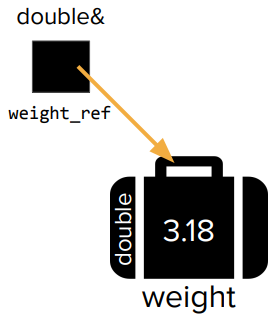
何时不使用引用传递?#
- 如果我们总是使用引用,那么函数之间都可以互相修改对方的变量,程序的作用域会变得混乱
- 当数据本身很小(即按值复制的成本很低)时,我们就不需要使用引用
- 如果参数是引用,不能传入字面值
❌错误示例
void tripleWeight(double& weight_ref);
...
tripleWeight(1.06);//别这么做!编译器出错 1.06是一个临时值,没有实际存储位置,不能被引用修改
5.有序数据结构#
当说“无序”与“有序”时,我们特指数字排序
Vector#
- 从宏观层面来说,向量是相同类型元素的有序集合,其大小可以增长或缩小 (注意:与数学向量不同)
- 集合中的每个元素都有一个特定的位置, 或称索引
- 向量中的所有元素必须是同一类型, 与其他编程语言不同,单个向量不能包含混合类型的元素
- 向量在存储元素数量方面非常灵活, 可以轻松地添加和删除元素、查询当前包含的元素数量等
基本向量运算#
创建
vector<int> vec;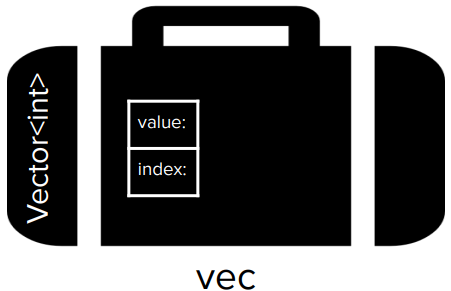
元素添加
vec.add(4);
vec.add(8);
vec.add(15);
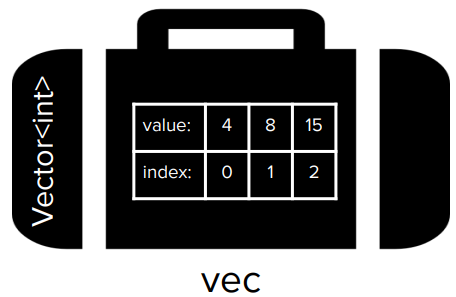 (注意:索引从
0开始)
创造 + 添加
vector<int> vec = {4, 8, 15};访问元素
cout << vec[1] << endl;(注意:cout << vec[3] << endl;这样做会抛出错误! Vector会进行边界检查, 不允许访问超出边界的元素)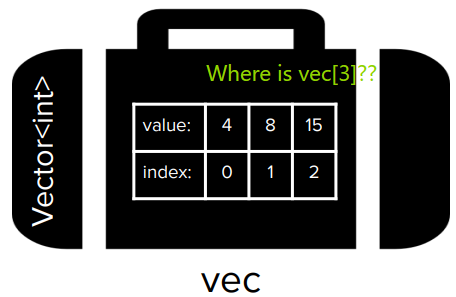
移除元素
vec.remove(0);(注意: index与value不绑定)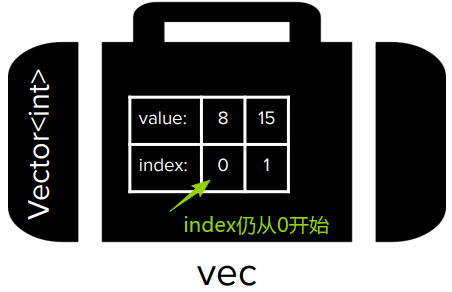
访问元素个数
cout << vec.size() << endl;output:2遍历向量
方法一:传统 for 循环
vector<int> vec = {1, 0, 6};

for (int i = 0; i < vec.size(); i++) {
    cout << vec[i] << endl;
}
方法二:for each 循环
 vector<int> vec = {1, 0, 6};

for (int value : vec) {
    cout << value << endl;
}
output: 1 0 6
Vector函数实用功能
vec.size():返回向量中元素的数量vec.isEmpty():判断向量是否为空,空返回true,否则返回false。vec[i]:访问向量中第i个元素vec.add(value):在向量末尾添加一个元素vec.insert(index, value):在指定位置index前插入元素,后面的元素向后移动一位vec.remove(index):删除指定位置的元素,后面的元素向前移动一位vec.clear():清空向量中的所有元素vec.sort():按升序排列向量中的元素
vector示例#
- 消除负数:给定一个整数向量,编写一个函数,通过改变向量中所有负值的符号,将它们转换为对应的正值,从而消除向量中的负数
void eliminateNegativity(vector<int> v)
{
  for (int i = 0; i < v.size(); i++)
  {
    if (v[i] < 0)
      v[i] *= -1; //负数 * -1
    cout << v[i] << endl;
  }
}

int main()
{
  vector<int> vec = {-1, 0, -4, 5};
  eliminateNegativity(vec);
  return 0;
}Grid#
这是Stanford封装好的类 Stanford Grid documentation
- 一个二维数组,具有特定的宽度和高度(注意:这里我们用数组而不是向量,因为它在创建的时候就确定了行数和列数,所以不像vector那样可以随意增加元素)
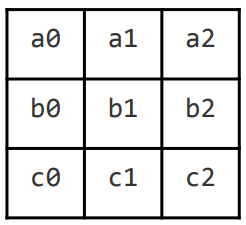
- 适用于电子表格、游戏棋盘等
- 声明Grid的三种方法
Grid<type> gridName; Grid<type> gridName(numRows, numCols); Grid<type> gridName = {{a0, a1, a2}, {b0, b1, b2},...}; - 实用功能
grid.numRows() //返回网格(grid)的行数 grid.numCols() //返回网格(grid)的列数 grid[i][j] //选择网格中第 i 行、第 j 列 的元素。 grid.resize(rows, cols) //改变网格的尺寸(行数和列数),并将所有元素重新初始化为它们的默认值 grid.inBounds(row, col) //如果指定的 行(row),列(col)位置在网格范围内,返回true,否则返回false - 如何遍历Grid
void printGrid(Grid<char>& grid) {
 for(int r = 0; r < grid.numRows(); r++) {
     for(int c = 0; c < grid.numCols(); c++) {
         cout << grid[r][c];
     }
     cout << endl;
  }
}

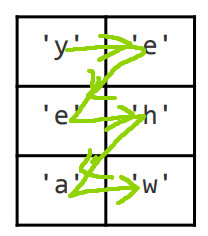
Grid<char> word = {{'y', 'e'}, {'e', 'h'}, {'a', 'w'}};
printGrid(word);
output:
ye
eh
aw
使用Grid时常见的陷阱
- 别忘了指定Grid中存储的数据类型
Grid word; //NO!Grid<char> word; //YES~- 与vector和其他抽象数据类型(ADT)一样,当网格用作函数参数时,应该按引用传递
& - 使用网格索引时要注意变量的顺序! 建议使用
r表示行,c表示列 - 与其他语言不同,您只能访问单元格(不能访问单个行)
grid[0]→ 这样做会导致错误
战舰游戏网格系统
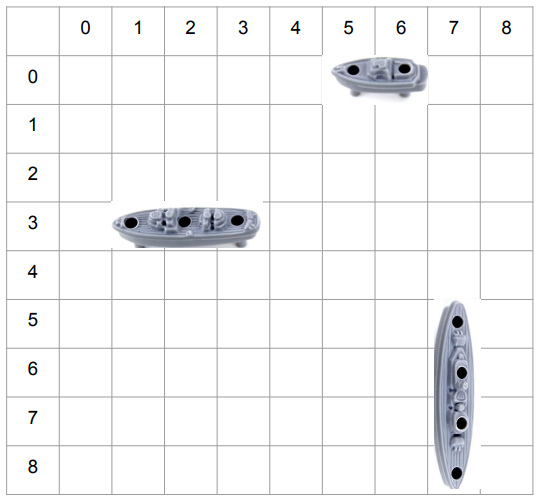
Structs + GridLocation#
什么是struct#
C++中将不同类型的信息捆绑在一起的方法——类似于创建自定义数据结构
GridLocation结构体#
- Stanford C++库中预定义的结构体,可以更方便地存储网格位置 (就像一个坐标表示系统)
struct GridLocation {
    int row;
    int col;
}                     //结构定义(可以是不同类型的成员)
- 要声明一个结构体,你可以分别给每个成员赋值,也可以在创建结构体时一次性赋值
GridLocation origin = {0, 0};
// or
GridLocation origin;
origin.row = 0;
origin.col = 0; //您可以使用点号表示法访问结构体中的成员 成员名后面不需要括号
Queue#
有Stanford封装好的类 Stanford Grid documentation
什么是Queue?#
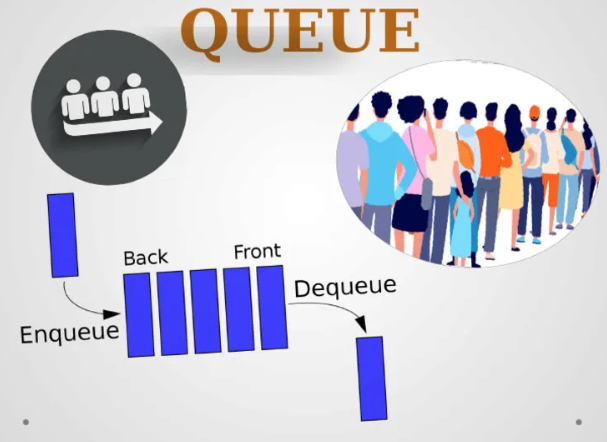
- 一种两端开放的线性数据结构
- 一个有序列表,允许在称为后部(REAR)的一端执行插入操作,在称为前部(FRONT)的另一端执行删除操作
- 先进先出(FIFO)列表 就像我们在食堂排队打饭一样 First person In is the First person Out
实用功能#
enqueue(value)  // or add(value )入队
dequeue()  // or remove() 离队 因为是先进先出 所以是移除首次添加的值
peek()  // or front() 查看队首
isEmpty() // 队列是否为空
Queue示例#
Queue<int> line; // {}, empty queue
line.enqueue(42); // {42}
line.enqueue(-3); // {42, -3}
line.enqueue(17); // {42, -3, 17}
cout << line.dequeue() << endl; // 取出42 (队列目前为 {-3, 17})
cout << line.peek() << endl; // 显示-3 (队列目前为 {-3, 17})
cout << line.dequeue() << endl; // 取出-3 (队列目前为 {17})

// or
Queue<int> line = {42, -3, 17};Stack#
什么是Stack#
- 遵循后来居上,后进先出(LIFO)原则的抽象数据结构(ADT) Last item In is the First one Out
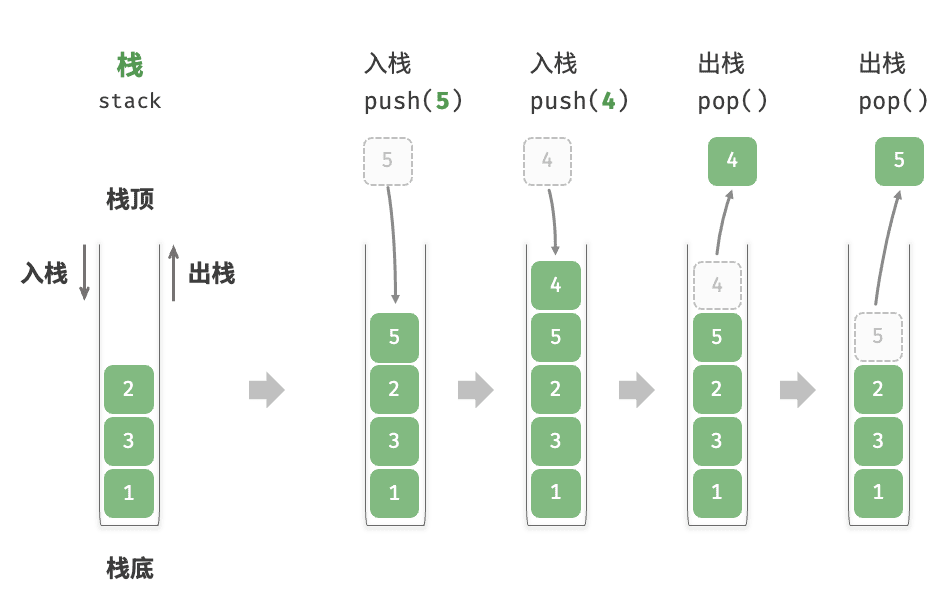
Stack与Queue常见操作#
Stack<string> wordStack; // {}, empty stack
wordStack.push("Kylie"); // {"Kylie"}
wordStack.push("Nick"); // {"Kylie", "Nick"}
wordStack.push("Trip"); // {"Kylie", "Nick", "Trip"}
cout << wordStack.pop() << endl; // “Trip”
cout << wordStack.peek() << endl; // "Nick"
cout << wordStack.pop() << endl; // "Nick" (stack is {"Kylie"})
// 直接表示
Stack<string> wordStack = {"Kylie", "Nick", "Trip"};
// 顶部 是最右边的元素Trip
- 清空队列/栈
//取出队列中的元素
Queue<int> queueIdiom1;
// produce: {1, 2, 3, 4, 5, 6}
for (int i = 1; i <= 6; i++) {
  queueIdiom1.enqueue(i);
}
while (!queueIdiom1.isEmpty()) {
  cout << queueIdiom1.dequeue() << " ";
}
cout << endl;
//output: 1 2 3 4 5 6

//取出栈中的元素
Stack<int> stackIdiom1;
// produce: {1, 2, 3, 4, 5, 6}
for (int i = 1; i <= 6; i++) {
  stackIdiom1.push(i);
}
while (!stackIdiom1.isEmpty()) {
  cout << stackIdiom1.pop() << " ";
}
cout << endl;
//output: 6 5 4 3 2 1
- 遍历和修改队列/栈 → 循环前只需计算一次大小
//队列
Queue<int> queueIdiom2 = {1,2,3,4,5,6};

int origQSize = queueIdiom2.size();

for (int i = 0; i < origQSize; i++) {
   int value = queueIdiom2.dequeue();
 // 只保留偶数
   if (value % 2 == 0) {
       queueIdiom2.enqueue(value);
   }
}
cout << queueIdiom2 << endl;
//output: 2, 4, 6

//栈
Stack<int> stackIdiom2 = {1,2,3,4,5,6};
Stack<int> result;

int origSSize = stackIdiom2.size();

for (int i = 0; i < origSSize; i++) {
  int value = stackIdiom2.pop();
 // stackIdiom2的偶数添加到result
  if (value % 2 == 0) {
      result.push(value);
  }
}
cout << result << endl;
//output: 6, 4, 2
Stack与Queue常见陷阱#
- 别在循环条件里用
.size()因为每一次循环size都会改变! 在循环开始前,应用一个固定变量把初始大小存起来 - 栈是一次性的! 队列有时候还可以提供只读的迭代器让我们从头扫到尾,但栈(Stack)不行!你想要遍历一个栈,唯一的办法就是不断地
pop()(弹出)它,而弹出来的元素就从原栈里消失了,在遍历前应先进行复制
Stack与Queue的缺点#
没有随机访问
你想看队伍中间的人是谁?对不起,没门! 不像Vector,Grid那样可以使用索引(index)😅
没有无副作用的遍历
在不破坏它们的前提下,你无法把里面所有的元素扫一遍,你想看后面的元素,必须先把前面的元素全扔掉(出队/出栈),遍历完了,这个容器也空了😐
没有简单的搜索方法
你想在栈或队列里找一个特定的值?不行! 你只能苦哈哈地一个一个弹出来比对,找完了还得想办法把倒出来的元素再装回去😑
6.挑选合适的ADT#
Stacks (LIFO 最后发生的,最先被处理)
文本编辑器中的撤销
你的浏览器网页的后退
Queues (FIFO 先来后到,排队办事)
斯坦福计算机系著名的LaIR答疑预约系统->学生做实验遇到bug了,在系统上登记排队等助教,助教肯定去辅导第一个登记的学生
客服热线->哪个客户先打进电话,谁就排在队伍最前面,一旦有客服空出来,就先接待谁
7.ADT目前为止总结#
| 类型 | 是否支持索引访问 | 示例 | 特点 |
|---|---|---|---|
| 可通过索引访问的有序ADT | ✅ 可以 | Vector, Grid | 灵活访问,适合遍历和按位置组织数据 |
| 无法通过索引访问元素的有序ADT | ❌ 不可以 | Queue, Stack | 限制访问方式,适合特定顺序处理 |
核心区别
Vector / Grid
- 关注 数据在哪里(where)
- 可以直接通过 index 找到元素
- 例如:
vector[3]; // 直接访问第4个元素
Queue / Stack
- 关注 数据处理顺序(how)
- 不允许随意访问中间元素
- 例如:
Queue:
First in → First out

Stack:
Last in → First out
8.无序数据结构#
为什么我们要使用无序ADT#
因为有时,使用数字索引/排序并不是存储信息的最有效方式!
无序数据示例#
- 网站独立访客数
- 随机播放列表,无重复歌曲
- 特定航班上的乘客及其护照号码
- 一份包含所有食材及其用量的食谱
- 社交媒体内容包含,文本,表情,图片,没有统一结构
Set#
什么是Set#
- 指不包含重复元素的元素的集合
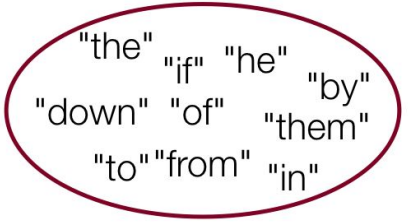
集合比向量等有序数据结构速度更快——因为集合中没有重复项,所以查找数据的速度更快
集合没有索引
使用功能#
如需查看完整列表,请查看Stanford libraries documentation
add(value) //向集合中添加一个值。如果集合里已经有这个值,则不重复添加
contains(value) //检查集合中是否包含某个值。包含返回 true,否则返回 false。
remove(value) //集合中删除某个值。如果这个值不存在,什么也不做
size() //返回集合中元素的数量
isEmpty() //判断集合是否为空。为空返回 true,否则返回 false
Set示例#
Set<string> friends;
friends.add("nick");
friends.add("kylie");
friends.add("trip");
// 也可以这样  Set<string> friends = {“nick”, “kylie”, “trip”};
cout << boolalpha << friends.contains("voldemort") << noboolalpha
    << endl;
for(string person : friends) {
    cout << person << endl;
}Set运算#
s1 == s2 如果两个集合包含完全一样的元素,返回 true 与s1 != s2相对
s1 + s2 并集
s1 * s2 交集
s1 - s2 差集 返回存在于s1中但不在s2中 的元素
(注意: 元素全不重复)
常见集合模式和陷阱#
- 使用for each循环遍历集合
for (type currElem : set) {
 // process elements one at a time
}- 任何试图对该集合进行索引的操作都不能使用
for (int i = 0;..) or set[i]
Map#
什么是Map#
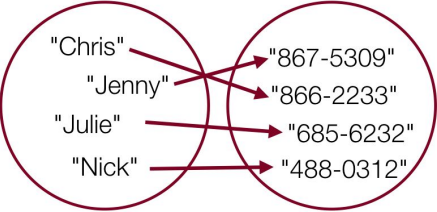
- Map(映射 / 哈希表) 是一种存储“键值对(key/value pair)”的数据结构
- 每个 key(键) 对应一个
value(值),通过key可以快速找到对应的value
实用功能#
m.clear() //清空 Map,删除所有键值对
m.containsKey(key) //判断 Map 是否包含指定的键。包含返回 true,否则返回 false
m[key] //or m.get(key) 获取指定 key 对应的 value,如果 key 不存在,返回 value 类型的默认值
m.isEmpty() //判断 Map 是否为空。没有任何键值对返回 true
m.keys() //返回 Map 中所有 key 的集合(Vector)
m[key] = value //or m.put(key, value) 添加一个键值对,如果 key 已存在,则更新它对应的 value
m.remove(key) //删除指定 key 的键值对,如果 key 不存在,不做任何操作
m.size() //返回 Map 中键值对的数量
m.values() //返回 Map 中所有 value 的集合(Vector)
Map示例#
// 将字符串键映射到字符串值
Map<string, string> phoneBook;

//插入新值
// key                value
phoneBook["Jenny"] = "867-5309"; // or
phoneBook.put("Jenny", "867-5309");

//访问值
string jennyNumber = phoneBook["Jenny"]; // or
string jennyNumber = phoneBook.get("Jenny");
cout << jennyNumber << endl;

// 将字符串键映射到 Vector<double> 值
Map<string, Vector<double>> accounts;常见映射表模式和陷阱#
- 使用for each循环遍历映射表
- 自动插入:一项map功能,但有时也会导致错误
Map<string, int> freqMap;
while (true) {
    string text = getLine("Enter some text: ");
    cout << "Times seen: " << freqMap[text] << endl;
    freqMap[text]++; //自动插入仅在使用 [] 运算符时才会发生,而不会使用 .get() 函数
 }
错误示例
Map<string, int> freqMap;
//...
// 获取密钥以测试它是否在地图中
if (freqMap[key] == 0) { // 这个判断永远是true
cout << key << " is in the map" << endl;
}
正确示例
Map<string, int> freqMap;
...
// 使用 containsKey 函数,不自动插入
if (freqMap.containsKey(key)) { // 正确的做法
    cout << key << " is in the map" << endl;
}ADT再次总结#
Ordered ADTs(有序抽象数据类型)#
数据有明确顺序,可以按照位置访问。
| 类型 | 通俗理解 |
|---|---|
| Vectors(向量 / 一维数组) | 像一排储物柜,每个元素都有编号,可以通过下标访问,例如 vec[3] |
| Grids(网格 / 二维数组) | 像棋盘一样,有行和列,可以通过两个坐标访问,例如 grid[2][5] |
| Queues(队列) | 像排队买票,只能从队尾加入,从队头取出,先进先出 FIFO(First In First Out) |
| Stacks(栈) | 像一摞盘子,只能从顶部放入和取出,后进先出 LIFO(Last In First Out) |
Unordered ADTs(无序抽象数据类型)#
数据没有固定顺序,不能依靠位置访问。
适合用于:数字排序没有意义,更关注“是否存在”或“快速查找”的情况。
| 类型 | 通俗理解 |
|---|---|
| Sets(集合) | 存储不重复的数据,每个元素只能出现一次,例如 {1,2,3} |
| Keys(键) | 每个键必须唯一,用来快速找到对应的数据,例如字典中的“单词 → 解释” |
9.使用抽象#
计数排序#
一种非比较型排序算法。它的核心思想是统计数组中每个元素出现的次数,并将这些统计结果用来直接计算每个元素在排序后数组中的正确位置,从而避免元素之间的两两比较
- 现在,让我们考虑这个问题:如何高效地将单词中的所有字母按字母顺序排序?
- 我们如何利用最近学到的一些数据结构,对要排序的数据进行有意义的结构化处理?
- 想法:如果我们统计出从“a”到“z”的每个字母出现的次数,我们就可以构建一个新字符串,该字符串由正确数量的“b”,……等等
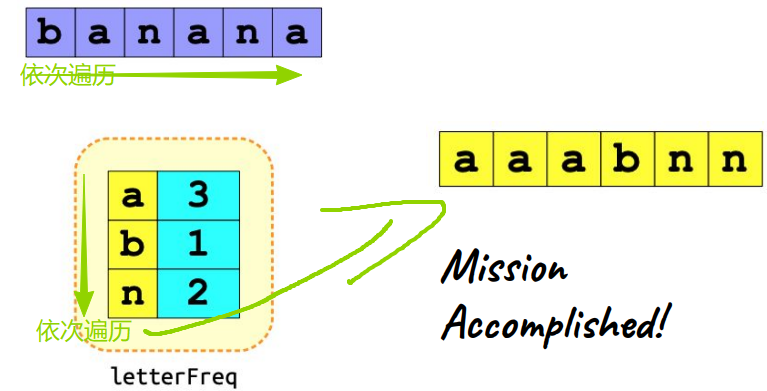
- 遍历单词并构建原始字符串中出现的所有字母的频率map (注意:它没有天然的“统计”功能,但ADT 不关心你存什么,只关心key-value关系)
- 遍历从 ‘a’ 到 ‘z’ 的所有字母,并构建一个包含相应数量字母的新字符串
- 返回新生成的字符串
string countingSort(string s) {

    map<char, int> freqMap;

    for (char ch: s) {
        freqMap[ch]++;
    }

    string sortedString;
    for (char ch = 'a'; ch <= 'z'; ch++) {
        for (int i = 0; i < freqMap[ch]; i++) { //如果ch不存在与s中,freqMap[ch] = 0
                sortedString.push_back(ch);
            }
        }
    return sortedString;
}单词梯问题#
给你两个单词,你需要像爬楼梯一样,一步一步改变字母,最后从起始单词变成目标单词,每一步得到的新单词都必须是真实存在的英文单词
COLD -> CORD -> CARD -> WARD -> WARM
一个直观想法是模拟人类解题过程:
- 从起始单词开始
- 猜测应该改变哪个字母
- 修改字母,生成新的合法英文单词
- 重复这个过程,直到:
- 到达目标单词
- 或走入死路,然后重新尝试
需要直觉#
人类可以凭经验判断下一步,但:
计算机没有“感觉”,不知道哪个方向更好
搜索无组织#
这种方法类似乱走迷宫:
- 不知道先探索哪里
- 可能重复尝试
- 没有记录搜索过程
无法保证找到答案#
即使存在解:
随机尝试也可能永远找不到正确路径
猜测 → 尝试 → 失败 → 重来 不适合计算机 那怎么办?🫤
BFS#
什么是BFS#
广度优先搜索(BFS) 一种逐层向外扩散的图遍历算法,它从起点开始,先访问所有直接相邻的节点,再依次访问邻居的邻居
              COLD
            /  |   \
        BOLD  CORD  SOLD
        /       |      \
   ❌  BALD     CARD    SORD  ❌
                 |
               WARD
                 |
WARMBFS所需要的数据结构#
| 功能 | 数据结构需求 | 常用 ADT |
|---|---|---|
| 保存一条路径 | 快速访问最后一个单词 | Vector / Stack |
| 保存等待探索的路径 | 按长度顺序处理 | Queue |
| 记录访问过的单词 | 快速查找是否存在 | Set |
核心思想:
BFS 不直接搜索单词,而是搜索可能的路径,每次扩展一层
解决单词梯问题#
初始化:
- 创建一个队列用于存放待处理的路径。
- 创建一个集合记录已访问过的单词(防止重复搜索)
- 将包含“起始单词”的路径存入队列
循环处理(当队列不为空时):
- 从队列中取出一个路径
- 取出路径末尾的单词作为“当前单词”
- 判断:如果当前单词等于“目标单词”,直接返回该路径,搜索结束。
扩展节点:
- 寻找所有与“当前单词”仅相差一个字母且合法的“邻居单词”。
- 遍历这些邻居:
- 如果该邻居尚未被访问过:
- 标记该邻居为“已访问”
- 复制当前路径,并将该邻居添加到路径末尾
- 将这条新路径加入队列尾部,继续下一轮探索
- 如果该邻居尚未被访问过:
BFS示例#
给你个
 vector<string> maze = {
        "S.....", // S为起点
        ".###..", // .表示路 #表示障碍
        "...#..",
        ".###..",
        "....E." // E为目标点 计算最短要走几步
    };
代码实现:
#include <iostream>
#include <vector>
#include <queue>
using namespace std;

struct node {
    int x;
    int y;
    int step;
    bool operator==(const node& other) {
        return (other.x == x && y == other.y);
    }
};

class bfs1 {
public:
    int bfs(vector<string> maze) {
        //初始化
        int n = maze.size();
        int m = maze[0].size();
        node s = {0, 0, 0};
        node e = {4, 4, 0};
        queue<node> q;
        vector<vector<int>> visited(n, vector<int>(m, 0)); //搜索状态  未访问:0 已访问:1
        visited[s.x][s.y] = true;
        q.push(s); //添加起始位置坐标

        while (!q.empty()) {
            node cur = q.front(); //记录队列中第一个元素
            q.pop();              //删除

            if (cur == e)
                return cur.step;

            //方向变化量
            int dx[4] = {-1, 1, 0, 0};
            int dy[4] = {0, 0, -1, 1};

            for (int i = 0; i < 4; i++) {
                //新坐标
                int nx = cur.x + dx[i];
                int ny = cur.y + dy[i];

                if (nx < 0 || nx >= n || ny < 0 || ny >=m) //越界访问
                    continue;
                if (maze[nx][ny] == '#') //遇到障碍
                    continue;
                if (visited[nx][ny]) //已访问过
                    continue;

                visited[nx][ny] = true; //访问记录
                q.push({nx, ny, cur.step + 1}); //添加新坐标并让step+1
            }
        }
        return -1; //如果队列为空
    }
};

int main()
{
    vector<string> maze = {
        "S.....",
        ".###..",
        "...#..",
        ".###..",
        "....E."
    };

    bfs1 test;
    cout << test.bfs(maze);
    return 0;
}
Nested ADT#
什么是Nested ADT#
一种数据结构里面包含另一种数据结构作为元素
- 对象里面放对象
- 哈希表里放列表
- 链表里面放树
Nested ADT示例#
假设我们正在设计一个系统,用来记录动物园中不同动物的喂食时间
- 需求:
- 如果我们知道动物的名字,我们需要能够快速查找该动物对应的喂食时间
- 我们需要能够为每一种动物存储多个喂食时间
- 喂食时间应该按照实际喂食发生的顺序进行存储
- 数据结构声明
map<string, vector<string>> feedingTimes;
这里有两个层级
- 动物名字 -> 喂食时间列表
- 一个动物 -> 多个时间
| 🐱 | 🐕 |
|---|---|
| 7:00 | 8:00 |
| 12:00 | 11:00 |
feedingTimes (map<string, vector<string>>)
|
+-- ["Cat"]
|      |
|      +-- vector<string>
|             |
|             +-- [0] --> "07:00"
|             |
|             +-- [1] --> "12:00"
|
+-- ["Dog"]
       |
       +-- vector<string>
              |
              +-- [0] --> "08:00"
              |
+-- [1] --> "11:00"feedingTimes["Cat"] = {"7:00", "9.00"};
cout << feedingTimes["Cat"][0]; //输出一个string "7:00"
“[]“操作符和”=“赋值操作符的细节区别#
- 当你使用 [] 运算符访问 map 中的元素时,你得到的是 map 中该元素的引用
假设
feedingTimes (map<string, vector<string>>)
|
+-- ["Cat"]
|      |
|      +-- vector<string>
|             |
|             +-- [0] --> "07:00"
|             |
| +-- [1] --> "12:00"执行feedingTimes["Cat"].add("14:00");
会变成
feedingTimes (map<string, vector<string>>)
|
+-- ["Cat"]
|      |
|      +-- vector<string>
|             |
|             +-- [0] --> "07:00"
|             |
|             +-- [1] --> "12:00"
|             |
| +-- [2] --> "14:00"- 但是,当你使用”=“把”[]“的结果赋值给一个变量时,你得到的是内部数据结构的一份复制
执行vector<string> times3 = feedingTimes["Cat"];与times3.add("14:00");
得到
feedingTimes (map<string, vector<string>>)
|
+-- ["Cat"]
|      |
|      +-- vector<string>
|             |
|             +-- [0] --> "07:00"
|             |
|             +-- [1] --> "12:00"


times3 (vector<string>)
  |
  +-- [0] --> "07:00"
  |
  +-- [1] --> "12:00"
  |
+-- [2] --> "14:00"可以发现feedingTimes["Cat"]没有任何变化
如何让修改保存 如果你选择把内部数据结构保存到变量中,那么必须显式重新赋值,才能让修改保存
重新放回去
feedingTimes["Cat"] = times3;或直接引用
vector<string>& times3 = feedingTimes["Cat"];
这点非常重要,因为很多程序bug都来自以为改了原件,实际上只改了副本
Nested ADT总结#
嵌套 ADT 很强大,可以表达复杂现实数据;但也很容易出错,因为多层结构增加理解成本,而 C++ 中引用和复制机制会影响数据是否真正被修改
10.Big O和算法分析#
算法效率为何重要?#
- 资源限制:执行低效的算法可能导致某些任务根本无法完成,即使你拥有无限的资源。
- 解决难题:高效的算法让我们能够在有限的资源下解决重要问题,并预测程序在处理未知问题时的行为表现。
- 时间对比:在寻找特殊数中,穷举搜索预估效率低下,而使用高效特定算法实际运行时间会减少许多
什么是Big O?#
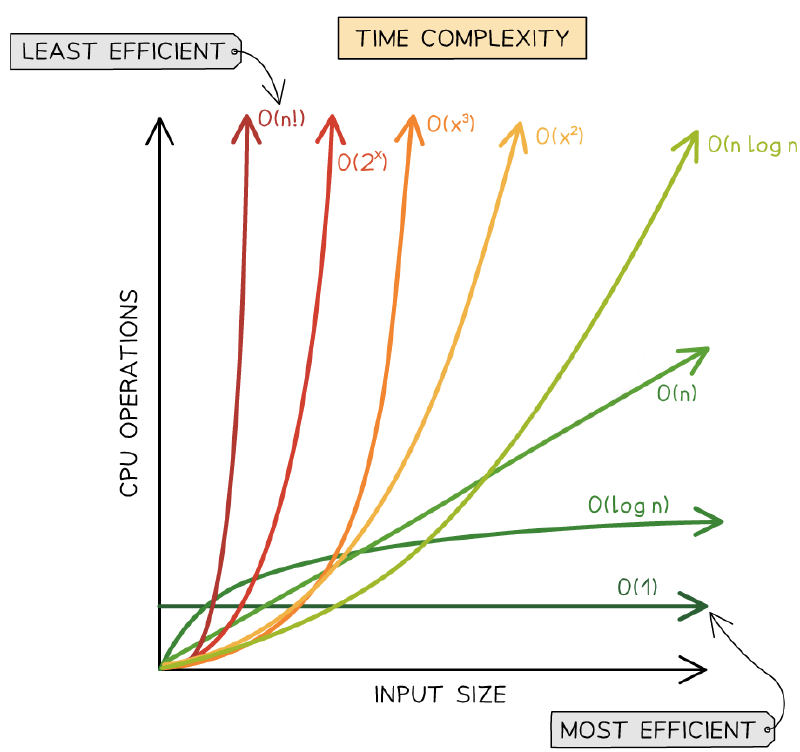
在计算机科学中,是一种用来描述算法 运行时间(时间) 或 内存消耗(空间) 如何随着输入数据量(通常用 n 表示)的增长而变化的数学符号
核心作用:大O表示法用于量化某个物理量(或运行时间)的增长率,它提供的是一种增长预测,而不是精确的计算公式
简单来说,它不衡量代码在某台特定硬件上跑了多少秒,而是衡量“当处理的数据量成倍增加时,算法所需的时间或空间会以怎样的趋势增长”,它通常用来表示算法在最坏情况下的性能上限
时间复杂度#
Big O时间复杂度示例#
此代码的BigO是多少呢 答案是 \(O(1+3n) = O(n)\)
for (int i = 1; i < n; i++)
{
	x++;
}
3n 为i < n,i++,x++ 1为 int i = 1
因为我们考虑的是n接近 \(∞\) 的情况下 所以1与3可以忽略不记
此代码的BigO是多少呢 答案是\(O(n^2)\)
for (int i = 1; i <= n; i++)
{
	for (int j = 1; j <= n; j++)
	{
		x++
	}
}
此代码的BigO是多少呢 答案是\(O(n+n^2) = O(n^2)\)
for (int i = 1; i < n; i++)
{
	x++;
}

for (int i = 1; i <= n; i++)
{
	for (int j = 1; j <= n; j++)
	{
		x++
	}
}代码运行时间分析#
- 运行时间的局限性:单纯依靠“计时”来衡量代码是不准确的,因为设备硬件、后台程序和电源状态等外界因素都会造成时间波动。
- 常数时间 \(O(1)\):无论输入数据
n有多大,代码的执行时间保持不变,这是最理想、最极速的算法表现 - 线性时间 \(O(n)\):运行时间与输入规模呈正比,如果输入规模翻倍,运行时间也大致翻倍(例如遍历查找 Vector 中的最大值)
- 二次方时间 \(O(n^2)\):运行时间呈二次方暴增(例如使用嵌套的双重
for循环打印矩阵),在输入规模变大时,程序会变得极其缓慢
抽象数据类型效率矩阵#
下表总结了各类数据结构常见操作的时间复杂度:
| 数据结构 (ADT) | 常数时间 \(O(1)\) 操作示例 | 线性时间 \(O(n)\) 操作示例 | 二次方时间 \(O(n^2)\) 操作示例 |
|---|---|---|---|
| Vectors (向量) | .size(), .add(), v[i] | .insert(), .remove(), .clear(), 遍历 | 无 |
| Grids (网格) | .numRows(), g[i][j], .inBounds() | 无 | 遍历 |
| Queues (队列) | .size(), .peek(), .enqueue(), .dequeue() | 遍历 | 无 |
| Stacks (栈) | .size(), .peek(), .push(), .pop() | 遍历 | 无 |
| Sets / Maps (集合/映射) | .size(), .isEmpty() | 遍历 | 无 |
空间复杂度#
Big O空间复杂度示例此代码的空间Big O是多少呢?答案是 \(O(1)\)
int sum = 0;
for (int i = 1; i <= n; i++)
{
	sum += i;
}
这里仅分配了常数个基础变量(sum 和 i),无论 n 接近 \(\infty\)时有多大,额外占用的内存都不会增加,因此是\(O(1)\)的原地操作
此代码的空间Big O是多少呢?答案是 \(O(n)\)
vector<int> v;
for (int i = 1; i <= n; i++)
{
	v.push_back(i);
}
代码中创建了一个动态数组/向量,并在其中存储了 n 个元素,随着输入规模 n 变大,内存占用呈线性增长
此代码的空间Big O是多少呢?答案是 \(O(n^2)\)
vector<vector<int>> matrix(n, vector<int>(n));
for (int i = 0; i < n; i++)
{
	for (int j = 0; j < n; j++)
	{
		matrix[i][j] = 0;
	}
}
代码在内存中开辟了一个 \(n \times n\)的二维网格,所需空间是宽与高的乘积,因此占用空间随 n 的二次方暴增
代码空间占用分析#
- 空间占用的侧重点:空间复杂度通常评估的是算法在运行过程中所需的额外辅助空间 ,而不是输入数据本身的大小
- 常数空间 \(O(1)\):无论输入数据 n 有多大,代码只需要固定大小的额外内存,这是最节省内存的理想状态
- 线性空间 \(O(n)\):额外占用的内存与输入规模呈正比,如果数据量翻倍,占用的额外内存也会大致翻倍
- 二次方空间 \(O(n^2)\):额外占用的内存呈二次方暴增,在数据规模变大时,极易导致内存溢出
抽象数据类型效率矩阵#
| 数据结构 (ADT) | 常数时间 \(O(1)\) 操作示例 | 线性时间 \(O(n)\) 操作示例 | 二次方时间 \(O(n^2)\) 操作示例 |
|---|---|---|---|
| Vectors (向量) | .size(), .add(), v[i]原地交换元素 | 整体存储, 深拷贝 .subList() | 无 |
| Grids (网格) | .numRows(), g[i][j], .inBounds() | 提取单行/单列的数据并返回新一维数组 | 整体存储 (假设尺寸为 \(n \times n\), 深拷贝整个网格 |
| Queues (队列) | .size(), .peek(), .enqueue(), .dequeue() | 整体存储, 深拷贝 | 无 |
| Stacks (栈) | .size(), .peek(), .push(), .pop() | 整体存储, 深拷贝 | 无 |
| Sets / Maps (集合/映射) | .size(), .isEmpty() 查改元素 (非递归) | 整体存储, 提取所有 Key/Value 组装成新列表 | 无 |
11.递归入门#
什么是递归?#
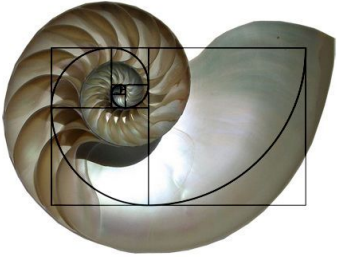
是迭代(循环)的强大替代方案,一种问题解决技巧,通过将任务分解成重复的、相同形式的较小任务来完成任务
常用于排序和搜索问题,也可用于表达自然界中观察到的模式
递归示例#
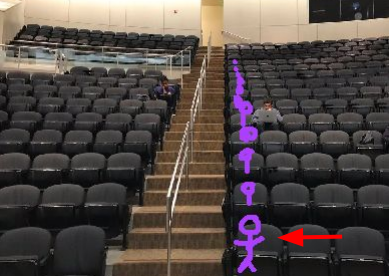
我想知道今天有多少人来上课,但我不想挨个走过去数🫤
我想寻求你们的帮助,但我也想尽量减少每个人的工作量
我们将专注于解决一列学生人数的问题
我们可以用递归法解决这个问题!🥳
- 我走到前排的第一个人面前,问:“在你这一列,正坐在你后面的人数有多少?”
- 规定学生的算法
- 如果没有人坐在我后面,回答 0
- 如果有人坐在我后面,问那个人:在你这一列,正坐在你后面的人数有多少
- 当他们回答一个数值 N 时,向问我的人回答 (N + 1)
假设有
A
B
C
D
E
---------------------
我问A
A: 后面有人 → 问 B
B: 后面有人 → 问 C
C: 后面有人 → 问 D
D: 后面有人 → 问 E

E: 后面没人 → 返回 0

D 收到 0 → 返回 0 + 1 = 1
C 收到 1 → 返回 1 + 1 = 2
B 收到 2 → 返回 2 + 1 = 3
A 收到 3 → 返回 3 + 1 = 4
---------------------
A 后面有 4 个人
总人数 = 4 + A自己 = 5
int count(Person* p)
{
if(p->behind == nullptr)
return 0;
return count(p->behind) + 1;
}(注意:递归不是体现在A得到答案之后怎么计算,A遇到问题后,把同一个问题交给了B,而B又把同一个问题交给了C…)
递归的两个主要情况#
- 基本情况
- 你的问题中最简单的版本,其他所有情况最终都会缩小到它
- 可以直接回答
- 不需要继续调用递归
- 是递归停止的地方
- 上一个例子:后面没有人,返回 0
- 你的问题中最简单的版本,其他所有情况最终都会缩小到它
- 递归情况
把更复杂的问题拆解成更小的、相同类型的问题
- 当前问题无法直接解决
- 需要依靠一个更小的问题的答案
- 相信递归调用最终会返回正确结果
- 上一个例子: 有人,让后面的人解决更小的问题,然后+1
递归信任跳跃:相信递归调用能解决小问题 (注意:它不是一个解决问题的方法,而是一种设计递归时的思考方式,它的作用不是保证你的代码正确,而是避免你陷入递归展开的细节,从而能够写出递归结构)
例如:用代码求:sum(n)=1+2+3+…+n
❌:sum(200)=200+sum(199)展开,然后想下一步怎么做( sum(199)是….? )
✔️:假设sum(199)正确,sum(200)=200+sum(199)必然正确 开始设计:假设sum(n-1)正确,sum(n)=n+sum(n-1)必然正确
int sum(int n)
{
    if(n == 1)
    {
        return 1;
    }
    else
    {
    	return n + sum(n - 1); //假设(相信)sum(n-1)正确
    }
}阶乘#
我们知道
5! = 5 x 4!
4! = 4 x 3!
3! = 3 x 2!
2! = 2 x 1!
1! = 1 x 0!
0! = 1
归纳
$$ n!=\left\{\begin{array}{ll} 1 & \text { if } n=0 \\ n \times(n-1)! & \text { otherwise } \end{array}\right. $$设计
int factorial(int n)
{
  if (n == 0)
  {
    return 1;
  }
  else
  {
    return n * factorial(n - 1);
  }
}

int main()
{
  int n = factorial(5);
  cout << "5! = " << n << endl;
  return 0;
}
一步步递归
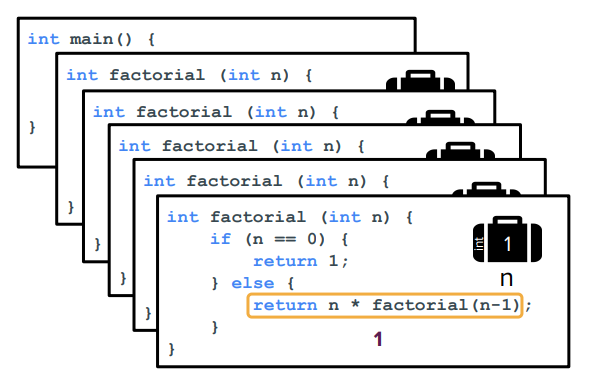
一步步返回结果
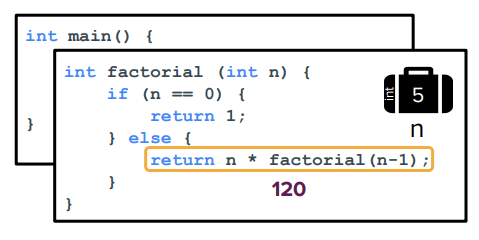
递归vs.迭代#
反向字符串示例#
      dog → god
 stressed → desserts
recursion → noisrucer
    level → level
        a → a
code
string fan(string str)
{
  if (str.empty()) //递归终止条件
    return "";

  string temp(1, str.back()); //取出最后一个字符
  str.pop_back();             //删除最后一个字符

  return temp + fan(str);     //拼接并返回
}总结#
- 递归是一种解决问题的技巧,它通过把一个任务不断拆分成规模更小、形式相同的子任务,来完成整个问题的求解
- 递归有两个主要部分
- 基本情况(base case):递归停止的条件,也就是最小规模问题的直接答案
- 递归情况(recursive case):把当前问题转化为一个更小规模的同类问题,并继续调用自己
- 答案会在返回调用栈(call stack)的过程中逐步构建出来
- 解决递归问题时,要寻找“自相似性(self-similarity)”,并思考每个栈帧(stack frame)中保存了哪些信息
12.递归分形#
我们如何利用视觉表征来理解递归?#
- 递归地解决问题和分析递归现象涉及识别自相似性
- 自相似性:如果一个对象包含自身的较小副本,则该对象是自相似的
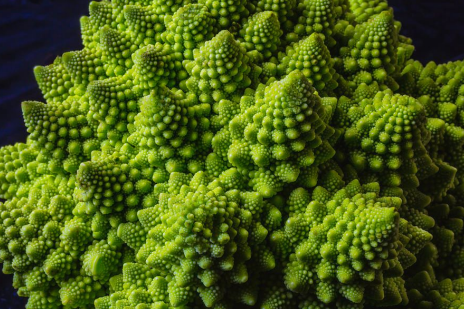
递归的图形表示#
递归的图形表示使我们能够可视化多次递归调用的结果
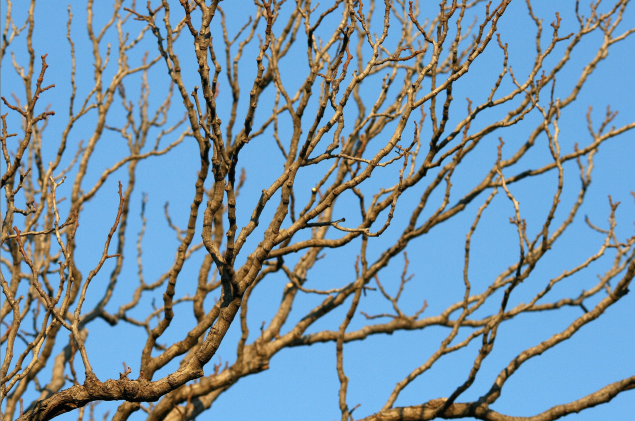
理解树的这种分支对于解决递归方面的难题至关重要
分形#
- 分形是指任何重复出现的图形图案
- 分形是由相同形状或图案的重复实例以结构化的方式排列而成的
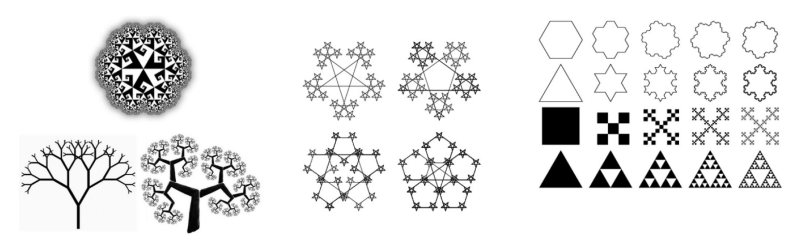
理解分形结构#
                    *
                    |
              *-----+-----*
              |           |
              *           *
          *---+---*   *---+---*
          |       |   |       |
          *       *   *       *
        *-+-*   *-+-* *-+-* *-+-*
        | | |   | | | | | | | | |
        * * *   * * * * * * * * *
就像我们学的树状图,每次递归调用只绘制一个分支,所有递归调用的总和就绘制出了整棵树
整体
 |
 +-- 部件(它自己也是整体)
        |
+-- 更小的自己13.高级递归#
迭代+递归#
- 在同一个函数中混合使用迭代和递归是完全合理的
- 递归并不意味着没有迭代,它只是意味着通过解决同一个问题的较小副本来解决同一个问题
- 迭代和递归结合起来会非常强大
为什么我们使用递归?#
- 优雅 它使我们能够用非常简洁的代码解决问题
- 高效 使我们能够在解决问题时获得更好的运行时间
- 动态 它使我们能够解决那些难以通过迭代解决的问题
一个绝妙的例子#
规则:
- 一次只能移动一个盘子
- 大盘不能放在小盘上面
- 目标:把所有盘子从 A 移到 C
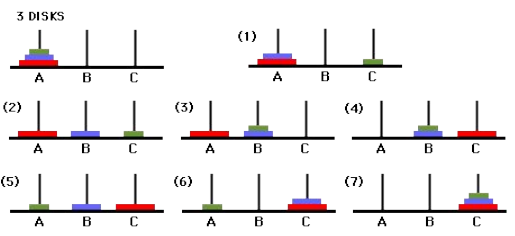
- 我们首先要想办法把最大的圆盘移到目标位置
- 然后需要将中间三块板从辅助区域移动到目标区域
我们想移动最大的盘子 3,但是盘子 1、2 挡住了它,所以必须先把上面的两个盘子移走,问题变成把 2 个盘子从 A 移到 B
思路关键:n-1 个盘子的问题,和原问题结构 n 个盘子一样!
递归信任:相信更小规模的问题已经有正确解决方法
void hanoi(int n, char from, char temp, char to)
{
  if (n == 1)
  {
    cout << from << " -> " << to << endl;
    return;
  }

  // 把 n-1 个盘子移动到辅助柱
  hanoi(n - 1, from, to, temp);

  // 移动最大的盘子
  cout << from << " -> " << to << endl;

  // 把 n-1 个盘子移动到目标柱
  hanoi(n - 1, temp, from, to);
}

int main() {
  hanoi(3, 'A', 'B', 'C');

  return 0;
}二分查找#
在已排序列表中查找数字89
想法一:我们可以按顺序遍历每个元素,进行线性搜索
我们能否做得更好?我们能否利用数据的结构优势? (注意:集合和映射实际上并不使用排序列表来存储信息,但搜索排序数据的总体思路是类似的)
想法二:二分查找
每一步都剔除一半的数据
递归定义二分查找
- 算法:检查中间元素
(startIndex + endIndex) / 2如果中间元素大于所需值,则删除右半部分数据并重复上述步骤 如果中间元素小于所需值,则删除数据左半部分并重复操作
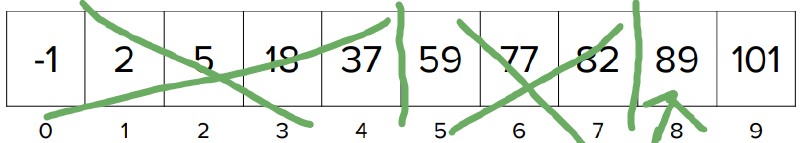
- 递归情况
- 中间的元素太小 → 二分查找(数据右半部分
- 中间元素过大 → 二分查找(数据左半部分)
- 基本情况
- 中间的元素
==所需元素 - 所查元素不在数据中
- 中间的元素
// 内部辅助函数(实际负责二分查找)
int binarySearchHelper(const vector<int>& v, int targetVal, int left, int right) {
    if (left > right) return -1; //Base cases

    int mid = left + (right - left) / 2;

    if (v[mid] == targetVal) return mid; //Base cases
    if (v[mid] > targetVal)  return binarySearchHelper(v, targetVal, left, mid - 1);
    return binarySearchHelper(v, targetVal, mid + 1, right); //Recursive cases
}

// 外部主函数(自动获取 vector 的首尾索引)
int binarySearch(vector<int>& v, int targetVal) {
    if (v.empty()) return -1; //Base cases
    return binarySearchHelper(v, targetVal, 0, v.size() - 1); //Recursive cases
}
大多数情况下,分而治之(\(O(log n)\) )会比线性运行(\(O(n)\))更快
迭代的局限#
- 到目前为止,我们已经看到了一些可以用迭代或者递归解决的问题
- 然而,还有一大类问题,使用迭代方法非常困难,甚至几乎不可能解决
- 为了解决这些问题,并生成大量可能的解决方案,我们需要学习一种新的问题解决技术,叫做递归回溯
递归回溯#
- 递归回溯的核心步骤是:
- 做出一个选择 你决定如何生成一个可能的解决方案
- 使用递归探索这个选择 通过递归继续深入,看看这个选择是否能产生有效结果
- 撤销这个选择 如果这个选择没有得到想要的结果,就回退,取消刚才的选择,然后尝试其他可能 假设要走迷宫
开始
 |
 +-- 左边
 |    |
 |    +-- 死路 ❌
 |
 +-- 右边
      |
+-- 出口 ✅普通迭代思维:我应该写多少个循环才能覆盖所有路线?
会非常困难,因为路线数量可能无限增长
递归回溯
choose:
    选择走左边

explore:
    继续探索左边的路

unchoose:
    发现死路,回来

choose:
    改走右边
生成硬币序列
你正在玩一个游戏,需要连续抛硬币若干次。 游戏的成功与否取决于你得到的正面(heads)和反面(tails)的精确顺序
抛3次硬币
HHT
THT
TTT
HTH
...
不同的序列可能导致不同结果
我们能不能发现 2 次抛硬币和 3 次抛硬币结果之间的规律? 答案是:可以
- 两次抛硬币的所有可能结果
        ""
       /  \
      H    T
     / \  / \
   HH HT TH TT
一共\(2^2=4\) 种结果
- 三次抛硬币的所有可能结果
              ""
            /    \
           H      T
         /  \    /  \
        HH  HT  TH  TT

HHH HHT HTH HTT THH THT TTH TTT
一共 \(2^3=8\) 种结果
它们之间有什么关系?
自相似的树状关系
无论你已经抛了多少次硬币,后面的结构都是一样的
例如:已经得到 HT,下一次 HT + H = HTH,HT + T = HTT,每一个节点都会分裂成两个新的可能
树的分支来自哪里?
分支来自一个选择,即是否给当前序列添加 H 或 T
这些连续的选择组成了一棵决策树,每条从根节点到叶节点的路径,就是一个完整方案
和递归回溯有什么关系?
choose:
    选择 H 或 T

explore:
    递归生成剩余位置

unchoose:
    删除刚才选择,尝试另一种可能
void generate(string soFar, int length)
{
if (soFar.length() == length)
{
cout << soFar << endl;
return;
}
generate(soFar + "H", length);
generate(soFar + "T", length);
}
int main() {
string str = "";
generate(str, 3);
return 0;
}
/*
output:
HHH
HHT
HTH
HTT
THH
THT
TTH
TTT
*/递归负责沿着树向下探索,回溯负责尝试不同分支
递归总结#
为什么使用递归?
优雅 允许我们使用非常简洁、清晰的代码解决问题。
高效 在解决某些问题时,递归可以帮助我们获得更好的运行效率
灵活 允许我们解决一些使用迭代方法很难解决的问题
两种递归类型
基础递归
一个重复执行的任务,在递归调用返回时逐渐构建答案
最终的 基本情况 定义了解决方案的初始种子
每一次递归调用都会为最终答案贡献一小部分
对递归函数的最初调用最终会产生完整的解决方案
回溯递归
- 递归+排列
- 通过每一步做出多个选择,使用多次递归调用来构建所有可能的解决方案
- 初始递归调用通常从一个空的方案开始
- 每一次递归调用代表我现在做一个选择,然后继续探索这个选择产生的后果
- 当达到叶节点时,当前路径就是一个可能的完整解决方案
14.回溯递归与枚举#
- 利用回溯递归,我们可以解决以下三大类问题:
- 生成问题的所有可能解或计算问题可能解的总数
- 找到问题的一个特定解或证明该解的存在
- 找到给定问题的最优解
- 我们可以解决的具体问题有很多很多 生成排列、生成子集、生成组合等等
游戏Jumble#
游戏给你一些被打乱的单词 你需要重新排列字母,猜出原来的单词
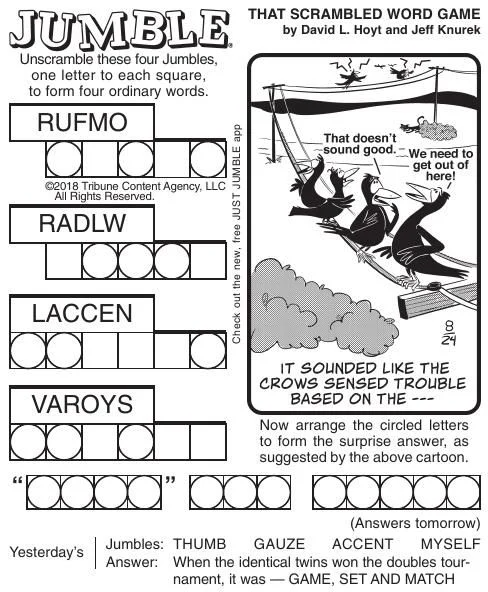
排列#
- 一个序列的排列是指一个序列,其元素与原序列相同,但顺序可能不同
- 我们可以把排列看作抛硬币序列的延伸,与只有正面和反面两种固定结果不同 -与其说是只有 2 个固定选项(正面和反面),不如说我们原始序列的组成部分定义了我们可以用来构建新序列的选项
我们的排列决策树由什么定义?
- 每一步(树的每一层)的决策 接下来要添加到排列中的字母是什么?
- 每个决策点的选项(每个节点的分支)
- 对于尚未选择的剩余元素,每个元素都有一个选项
- 注意:树的每一层选项数量都不同
- 我们沿途需要存储的信息
- 你目前构建的排列组合
- 原始序列中剩余的元素
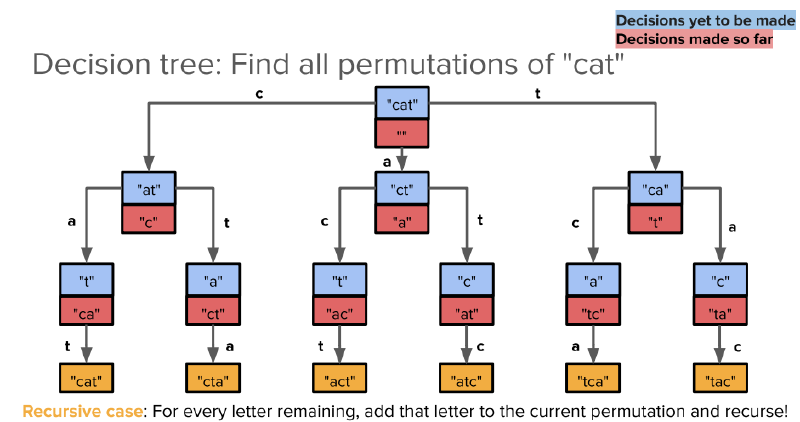
void listPermutationsHelper(string remaining, string soFar)
{
  if (remaining.empty())
    cout << soFar <<endl;
  else
  {
    for (int i = 0; i < remaining.length(); i++)
    {
      char nextLetter = remaining[i];
      string rest = remaining.substr(0, i) + remaining.substr(i + 1);
      listPermutationsHelper(rest, soFar + nextLetter);
    }

  }
}

void listPermutations(string s)
{
  listPermutationsHelper(s, "");
}
\(Permutations(S)=x∈S⋃x+Permutations(S−{x})\)
一个集合的所有排列 = 选择其中一个元素作为开头 + 对剩余元素求排列
子集#
给定一群人,假设我们想要生成这些人的所有可能团队或子集
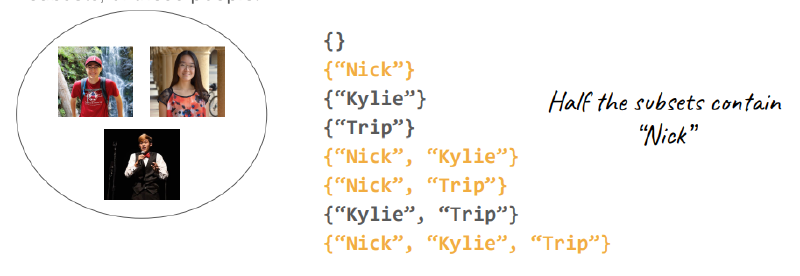
对于生成子集(以及思考决策)的计算机来说,我们可能会注意到另一种模式……
一半的子集包含“Nick”,一半的子集包含“Kylie”,一半的子集包含“Trip”,同时包含“Trip”和“Nick”的子集中有一半包含“Kylie”🧐
我们的子集决策树定义了什么?
- 每一步(树的每一层)的决策是:是否将给定的元素包含在我们的子集中?
- 每个决策的选项(每个节点的分支)
- 包含元素
- 不包含元素
- 我们需要存储的信息
- 目前构建的集合
- 原始集合中剩余的元素
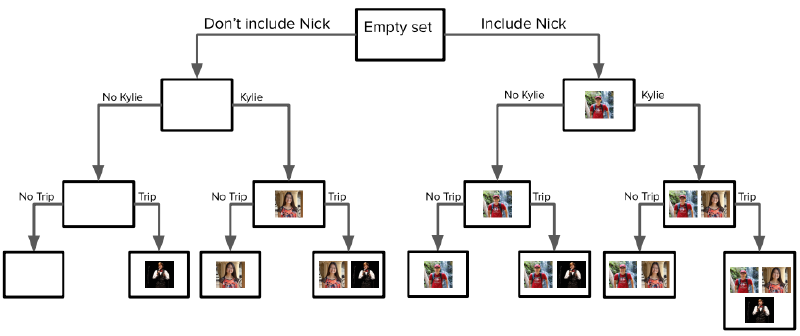
void printsubset(vector<string> team)
{
  for (int i =0 ; i < team.size(); i++)
  {
    cout << team[i] << endl;
  }
  cout << endl;
}

void generateTeams(vector<string>& people, vector<string>& team, int index)
{
  if (index == people.size())
  {
    printsubset(team);
    return;
  }

    // 选择当前人
  team.push_back(people[index]);
  generateTeams(people, team, index + 1);

    // 不选择当前人
  team.pop_back();
  generateTeams(people, team, index + 1);
}

void generateTeamsHelper(vector<string> people)
{
  vector<string> team;
  generateTeams(people, team, 0);
}

int main()
{

  vector<string> people = {"Nick", "Kylie", "Trip"};
  generateTeamsHelper(people);
  return 0;
}要点#
- 我们用来生成排列的回溯递归中的“一般‘选择 / 探索 / 不选择’模式”的具体模型可以理解为“复制、编辑、递归”
- 在回溯递归的每一步,记录我们到目前为止做过的决定以及还有哪些决定需要做很重要
- 回溯递归在每一层可能有不同的分支因子
- 常见做法是使用辅助函数和初始为空的参数,然后逐步构建
特殊子集#
Nick, Kylie, Trip
三人都有一个偏见值 vector<int> bias = {3, -2, -1}; 要求: 输出偏见值总和为0的子集
在上个例子中 基本情况下我们做的是打印所有的子集,如果我们只打印符合条件的子集不就行了
void generateTeams(vector<int>& people, vector<int>& team, int index, int currentSum)
{
  if (index == people.size())
  {
    if (currentSum == 0)
    {
      printsubst(team);
    }

    return;
  }

  team.push_back(people[index]); //选择
  generateTeams(people, team, index + 1, currentSum + people[index]);
  team.pop_back(); //回退
  generateTeams(people, team, index + 1, currentSum); //不选择
}迷宫#
给你一个迷宫使用递归找到它的一个正确路径并打印
vector<string> maze = {
    "#######",
    "#S#  E#",
    "# # # #",
    "#   # #",
    "#######"
什么定义了我们的迷宫决策树
- 每一步的决策(树的每一层)
- 走左,走右,走上,走下
- 每个决策的选项(节点的分支)
- 在地图范围内
- 不是墙
- 没有访问过
- 递归过程中需要保存的信息
- 已经走过的路径
- 哪些地方访问过
- 当前所在位置
bool solveMaze(vector<string>& maze, int row, int col, vector<pair<int, int>>& path, vector<vector<bool>>& visited)
{
  if (maze[row][col] == 'E') //基本情况
  {
    path.push_back({row,col}); //记录正确路径
    return true;
  }

  visited[row][col] = true; //标记访问过的地方
  path.push_back({row, col}); //添加路径

  int dr[4] = {-1, 1, 0, 0};// 四个方向
  int dc[4] = { 0, 0,-1, 1};

  for (int i = 0; i < 4; i++) //循环四个方向
  {
    int nr = row + dr[i]; //下一步的位置
    int nc = col + dc[i];

    if (nr >= 0 && nr < maze.size() && nc >= 0 && nc < maze[0].size() && maze[nr][nc] != '#' && !visited[nr][nc]) //下一步位置是否可走
    {
      //新一轮 如果true则找到终点 如果false则继续for循环 直到所有路径失败则返回上一个栈帧个false 让它尝试其他格子的四个方向
      if (solveMaze(maze, nr, nc, path, visited))
      {
        return true;
      }
    // else
    //   return false 错误 这样是给第一个solveMaz false
    }
  }
  path.pop_back();
  return false; //这个false是给 上一个栈帧 也就是上面的if()里的solveMaze 不是第一个solveMaze
}

int main()
{
  vector<string> maze = {
    "#######",
    "#S#  E#",
    "# # # #",
    "#   # #",
    "#######"
};
  vector<pair<int, int>> path;
  vector<vector<bool>> visited(maze.size(), vector<bool>(maze[0].size(), false));

  if(solveMaze(maze,1,1,path,visited))
  {
    for(auto p:path)
    {
      cout << "("
           << p.first
           << ","
           << p.second
           << ")"
           << endl;
    }
  }
  else
  {
    cout << "No path";
  }
  return 0;
}
NOT END
递归就是深度优先搜索(DFS)!
BFS vs DFS#
- BFS通常是迭代的,而DFS则自然地以递归的方式表达
- 虽然在这种特定情况下DFS速度更快,但具体使用哪种搜索策略取决于你要解决的问题
- BFS 会先查看特定长度的所有路径,然后再处理更长的路径,因此它保证能找到最短路径
- DFS不需要存储沿途的所有部分路径,因此它的内存占用比BFS更小
总结#
回溯递归:探索多种可能的解决方案
总体范式:选择/探索/取消选择
两种实现方式
| 方法 | 说明 | 特点 | 示例 |
|---|---|---|---|
| 选择-探索-撤销 | 使用引用传递(pass by reference),通常用于较大的数据结构 | 通过显式的 undo(撤销)步骤,恢复之前对数据结构的修改 | 生成子集(使用一个通过引用传递的集合,记录当前生成的子集) |
| 复制-修改-探索 | 使用值传递(pass by value),通常在内存限制不严格时使用 | 通过修改副本实现隐式撤销,不需要手动恢复状态 | 随着递归过程逐渐构建一个字符串 |
回溯的三种使用场景
| 类型 | 说明 |
|---|---|
| 生成 / 统计所有解 | 枚举所有可能的答案 |
| 寻找一个解 | 找到一个可行方案,或者证明不存在方案 |
| 选择最优解 | 在所有可能方案中找到最佳方案 |
回溯算法常见问题类型
| 类型 | 示例 |
|---|---|
| 排列 | 生成所有元素的排列顺序 |
| 子集 | 生成所有可能的集合 |
| 组合 | 从元素中选择指定数量的组合 |
| 等等 | 其他需要探索所有可能性的搜索问题 |
核心思想总结
回溯算法就是:
- 做出一个选择(Choose)
- 递归探索这个选择带来的结果(Explore)
- 撤销选择,回到之前状态(Unchoose)
- 尝试其他可能的选择
它本质上是在一棵「决策树」中不断尝试不同路径
15. 递归优化及复习#
我们如何利用递归回溯法找到极具挑战性问题的最佳解决方案?
组合#
要确立一项先例,至少需要五位美国最高法院大法官同意,有哪些方法可以选出这五位美国最高法院大法官?
子集与组合
- 我们的目标:我们想从9名法官中选出5名
- 这听起来和我们生成子集时解决的问题非常相似——这5位法官是9位法官的子集
- 组合与子集有何区别?
- 组合始终具有指定的大小,而子集的大小可以是任意的
- 我们可以将组合视为带有约束的子集
- 我们能否使用S上一节的代码,生成所有子集,然后筛选掉所有大小为5的子集
- 可以,但这效率太低。让我们开发一种更好的组合方法吧!
生成组合
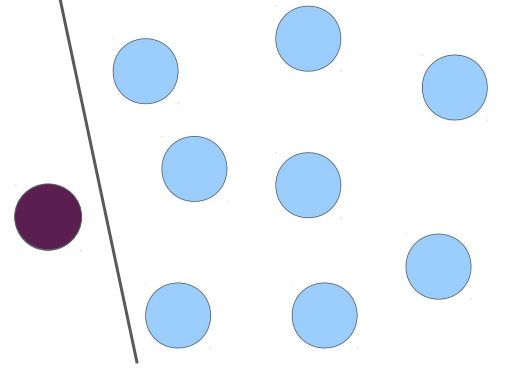
- 一种方法是排除第一个元素,然后从剩下的8个元素中选择5个元素
- 另一种是是包含第一个元素,然后从剩下的8个元素中选择4个元素
编写构建组合的函数
- k 个字符串的每种组合都可以表示为
set<string> - 以前,我们只是简单地打印出所有的解,但如果我们想把所有的解都保存下来,以便以后进行处理呢?
- 我们希望返回一个包含所有可能组合的容器
set<set<string>>(这种容器嵌套方式并不罕见) 这是我们的函数返回类型 - 基本情况
{A,B,C,D,E,} {F,G}
or
{ }{C,D}
无需继续寻找!我们可以返回一个集合,其中包含我们目前为止选择的所有对象 这都是我们的基本情况!
如何定义组合决策树
                    开始
                     |
                    A?
                  /    \
              不选A     选A
               /          \
              B?          B?
            /   \        /   \
         不选B  选B  不选B  选B
           |      |      |      |
C? C? C? C?- 每一步(树的每一层)的决策
- 是否将给定元素包含在我们的组合中?
- 每个决策点的选项(每个节点的分支)
- 包含元素
- 不包含元素
- 我们需要在此过程中存储的信息
- 目前已构建的组合
- 剩余可供选择的元素
- 剩余的待填充位置数量
伪代码
set<set<string>> combinationsRec(set<string>& remaining, int k, set<string>& chosen)
- 递归情况
- 选择:从剩余元素中选择一个元素
- 探索:尝试包含和排除该元素,并存储结果集合
- 返回包含和排除两种情况下返回的集合的组合(注意:这与我们通常的递归模式不同!)
- 基本情况
- 没有剩余元素可供选择—>返回空集
- 已选元素已满(
k已达最大值)->返回已选元素的集合
set<set<char>> combinationsRec(set<char>& remaining, int k, set<char>& chosen)
{
  if (k == 0) //基本情况
  {
    return {chosen};
  }

  if (remaining.size() < k)
  {
    return {};
  }

  set<set<char>> result;
  char first = *remaining.begin();
  //选择
  remaining.erase(first);

  //探索
  chosen.insert(first);
  auto include = combinationsRec(remaining, k - 1, chosen);
  result.insert(include.begin(), include.end());

  chosen.erase(first);
  auto exclude = combinationsRec(remaining, k, chosen);
  result.insert(exclude.begin(), exclude.end());

  //撤销
  remaining.insert(first);

  return result;
}

void combinationsRecHelper(set<char>& remaining)
{
  set<char> chosen;
  auto result = combinationsRec(remaining, 3, chosen);
  for (set<char> i : result)
  {
    for (char j : i)
    {
      cout << j << " ";
    }
    cout << endl;
  }
}

int main()
{
  set<char>remaining = {'a', 'b', 'c' ,'d', 'e', 'f'};
  combinationsRecHelper(remaining);
  return 0;
}递归优化#
Hard Problems#
- 计算机科学中有很多不同类别的问题都被认为是“难以”解决的
- 正式来说,这些问题被称为“NP难题” 选修CS103课程可以了解更多!
- 对于这类问题,目前尚无已知的“好”或“高效”的方法来找到问题的最佳解决方案,唯一已知的方法是尝试所有可能的解决方案,然后选择最佳方案
- 这些问题通常涉及寻找排列\(O(n!)\)种可能的解决方案or组合\(O(2^n)\)种可能的解决方案)
- 回溯递归正是解决这类穷举搜索问题的一种优雅且常用的编程方式
背包问题#
- 想象一下,你成为了一名专业的野外生存专家,开启了全新的生活
- 你即将踏上一段充满挑战的探险之旅,需要将补给装满背包的物品
- 你有一份清单,上面列满了各种物资(每种物资都有其生存价值和重量)
- 你的背包只能承受一定的重量
- 问题:如何才能最大限度地发挥背包的生存价值?
递归方法
思路:枚举权重小于等于 5 的所有子集,并选择总价值最高的子集(这是在生成组合我们最后一个回溯用例是:选择一个最佳解决方案 即优化) 我们需要跟踪所积累的总价值,但对于这个问题,我们暂时无需担心找到最佳的物品子集本身
我们的背包决策树由什么构成?
- 每一步(树的每一层)的决策:
- 是否将某个物品纳入组合?
- 每个决策的选项(每个节点的分支):
- 包含该物品
- 不包含该物品
- 我们需要存储的信息:
- 目前为止的总价值
- 剩余的可选物品
- 背包的剩余容量(重量)
targetWeight = 10; //背包容量

struct BackpackItem
{
  string name;
  int value; //生存价值
  int weight; //重量
};

 vector<BackpackItem> items = {
    {"Water", 10, 5},
    {"Knife", 6, 3},
    {"Food", 8, 4},
    {"Compass", 4, 2},
    {"Tent", 12, 7}
  };
int fillBackpack(vector<BackpackItem>& items, int targetWeight);
假设我们定义了一个自定义的 BackpackItem 结构体,它包含物品的生存值(int)和重量(int)
我们需要返回在 targetWeight 下,所有物品组合所能达到的最大值
我们需要一个辅助函数
int fillBackpackHelper (vector<BackpackItem>& items, int capacityRemaining, int curValue, int index);
为了提高效率,我们将使用索引来跟踪 items 中我们已经查看过的项
伪代码
- 递归情况:
- 根据索引选择一个未考虑的物品
- 递归地计算包含和不包含该物品时的值
- 返回较高的值
- 基本情况:
- 背包容量已满 → 返回 0(重量小于等于 5 时,这不是有效的组合)
- 没有更多物品可供选择 → curValue
struct BackpackItem
{
  string name;
  int value; // 生存价值
  int weight; // 重量
};

int fillBackpackHelper(vector<BackpackItem> &items, int capacityRemaining,
                       int curValue, int index)
{
  if (index == items.size() || capacityRemaining == 0) // 基本情况
  {
    return curValue;
  }

  // 不选择 without得到的“不选择当前物品后,下面整棵子树能得到的最大价值”
  int without =
      fillBackpackHelper(items, capacityRemaining, curValue, index + 1);

  // 选择 with得到的是“选择当前物品后,下面整棵子树能得到的最大价值”
  int with = curValue;
  if (items[index].weight <= capacityRemaining)
  {
    with = fillBackpackHelper(items, capacityRemaining - items[index].weight,
                              curValue + items[index].value, index + 1);
  }
  else
  {
    with = 0;
  }
  return max(without, with);
}

int fillBackpack(vector<BackpackItem> &items, int targetWeight)
{
  return fillBackpackHelper(items, targetWeight, 0, 0);
}

int main()
{

  vector<BackpackItem> items = {{"Water", 10, 5},
                                {"Knife", 6, 3},
                                {"Food", 8, 4},
                                {"Compass", 4, 2},
                                {"Tent", 12, 7}};
  cout << fillBackpack(items, 10);
  return 0;
}另一种算法DP(可防止重复计算)
int dfs(vector<BackpackItem>& items, int cap, int index, vector<vector<int>> memo)
{
  if (index == items.size() || cap == 0) //基本情况
    return 0;
  if (memo[index][cap] != -1) //备忘录 如果再次出现相同情况直接返回之前算过的
    return memo[index][cap];

  int without = dfs(items, cap, index + 1, memo); //选择

  int with = 0;
  if (items[index].weight <= cap) //不选择
  {
    with = items[index].value + dfs(items, cap - items[index].weight, index + 1, memo);
  }

  memo[index][cap] = max(with, without);
  return memo[index][cap];

}

int fun(vector<BackpackItem> items, int tw)
{
  vector<vector<int>> memo(items.size(), vector<int>(tw + 1, -1)); //都初始化为 -1
  return dfs(items, tw, 0, memo);
}关于递归的结语#
现在你知道如何利用递归从不同的角度看待问题,从而找到简洁优雅的解决方案
你已经了解了如何使用递归回溯来枚举某种类型的所有对象,你可以利用它来找到问题的最佳解决方案
你已经了解了如何使用递归回溯来确定某件事是否可行,如果可行,则找到实现它的方法
恭喜你走到这一步
两种类型的递归
| 基础递归 | 回溯递归 |
|---|---|
| 一个重复执行的任务,在递归调用栈返回时逐步构建解决方案 | 通过每一步的多个递归调用,构建大量可能的解决方案 |
| 最终的 base case(终止条件)定义了方案的初始种子,每次递归调用都会为解决方案贡献一部分 | 初始递归调用通常携带一个“空”的解决方案作为开始 |
| 初始调用递归函数会直接产生最终解决方案 | 每到达一个 base case,都代表一个可能的解决方案 |
回溯递归:探索大量可能的解决方案
整体思想:choose / explore / unchoose
回溯的两种实现方式#
| 方法 | 特点 |
|---|---|
| Choose → Explore → Undo | - 通常使用引用传递(pass by reference) - 适用于大型数据结构 - 需要显式执行 unchoose(撤销之前对数据结构的修改) - 例:生成子集(subsets),通过引用传递集合来跟踪当前子集 |
| Copy → Edit → Explore | - 通常使用值传递(pass by value) - 当数据规模较小时可以使用 - 不需要显式 unchoose,因为复制本身实现了撤销 - 例:逐步构造字符串 |
回溯的三种应用场景#
| 类型 | 描述 |
|---|---|
| 1. 生成/统计所有解决方案 | 枚举所有可能情况,例如生成所有组合、排列、子集 |
| 2. 找到一个解决方案(或证明存在) | 找到满足条件的一个答案,例如迷宫路径 |
| 3. 找到最优解决方案 | 在所有可能方案中选择最佳方案,例如最大价值背包 |
回溯常见问题类型#
- 排列
- 子集
- 组合
- 等等
设计回溯策略时需要问自己的问题#
我的决策树是什么样的?
- 每一步有哪些选择?
- 需要记录哪些信息?
我的 base case 和递归情况是什么?
提供的函数原型和要求是什么?
- 是否需要额外的 helper 辅助函数?
我们是否关心到达解决方案所经过的路径?
- 是否需要记录选择过程?
这个问题属于哪一种回溯应用?
- 生成/统计所有方案?
- 找到一个方案?
- 找到最佳方案?
我们返回的解决方案是什么?
- 布尔值
- 最终结果
- 一组结果
- 等等
我们正在构建什么“可能性集合”来寻找答案?
- 子集
- 排列
- 组合
- 或其他结构?
16. 面向对象编程#
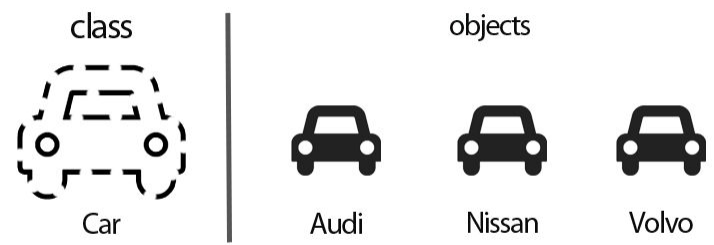
重新审视抽象#
抽象定义
这种设计隐藏了功能实现的细节,同时仍然允许用户访问复杂的功能
在*C++*中如何实现这一点?
使用类(class)
什么是类#
class定义了一种新的数据类型,供我们的程序使用(这听起来很耳熟)
还记得struct吗
struct BackpackItem {
   int survivalValue;
   int weight;
};
struct Juror {
   string name;
   int bias;
};
struct是*C++*中捆绑不同类型信息的一种方式,类似于创建自定义数据结构
那么类和结构体有什么区别呢?
结构体和类之间的唯一区别在于封装的默认设置
- 结构体默认使用公共成员(可在类外部访问)
- 类默认使用私有成员(仅在类实现内部可访问)
我们已经见过的类示例:vector、map、stack、queue (具体来说是类模板)
每个类都包含两个部分:
- 一个接口,用于指定可以对类的实例执行哪些操作(这定义了抽象边界)
- 指定如何执行那些操作的实现
什么是封装#
将相关信息和相关功能组合成一个单元,并确定该信息的访问途径
另一种思考类的方式
- 一种 C++ 对象 设计蓝图
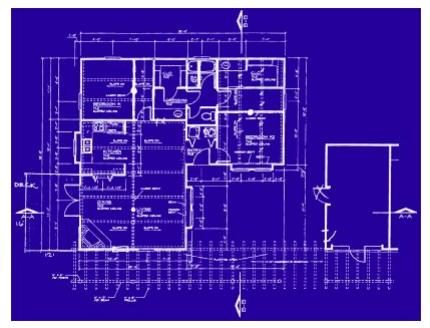
- 该蓝图描述了一个通用结构,我们可以使用此结构创建类的具体实例(用它来建房子)
什么是实例#
当我们创建一个属于我们新类型的对象时,我们称之为创建我们类的实例
vector<inr> vec; 创建 vector 类的一个实例(即vector类型的对象)
我们如何设计 C++ 类?#
三个主要部分
- 成员变量
- 这些是存储在类中的变量
- 通常无法在类实现之外访问
- 成员函数(方法)
- 可以对对象调用的函数
- 例如
vec.push_back()、vec.size()、vec.pop_back()等
- 构造函数
- 创建对象时调用
Vector<int> vec
我们必须明确的三个部分:
- 成员变量:这种新的变量类型由哪些子变量构成?
- 成员函数:可以对这种类型的变量调用哪些函数?
- 造函数:当您创建此类型的新实例时要发生什么?
一般来说,类对于帮助我们处理复杂的程序非常有用,因为在复杂的程序中,信息可以被分组到对象中
随机袋
- 随机袋是一种类似于stack或queue的数据结构。它支持两种操作:
- add 函数会将一个元素放入随机袋中
- remove random 函数会返回并从袋中移除一个随机元素
- 随机包装袋有多种用途:
- 更简单些:洗一副扑克牌
- 更高级的应用:生成艺术作品、设计迷宫以及训练自动驾驶汽车停车和变换车道
- 让我们来创建我们自己的自定义 RandomBag 类型吧!
创建类#
- 在 C++ 中定义一个类通常需要两个步骤:
- 创建一个头文件(通常以
.h为后缀),描述该类可以执行哪些操作以及它需要哪些内部状态 - 创建一个实现文件(通常以
.cpp为后缀),其中包含该类的实现 - 该类的使用者随后可以通过包含(使用
#include)头文件来使用该类
- 创建一个头文件(通常以
头文件(.h)#
//RangomBag.h
#pragma once //防止头文件重复包含
#include <vector>

class RandomBag { //定义类名
public: //公共部分
  void add(int value); //方法(成员函数)
  int removeRandom();
  int size(); const //使用const关键字的意思是“我保证这个函数不会改变对象的状态"
  bool isEmpty(); const

private: //私有部分
  vector<int> elems; //成员变量
};实现文件(.cpp中)#
#include "RandomBag.h"
using namespace std;

void RandomBag::add(int value) { //::运算符称为作用域解析运算符,用于指定查找对象的位置
	elems.push_back(value);
}

int RandomBag::removeRandom() {
if (elems.isEmpty()) {
	cout << "Aaaaahhh!";
	}

	int index = randomInteger(0, size() - 1); //这段代码调用了类内的`size()`函数,类的实现可以使用公共接口
	int result = elems[index];
	elems.pop_back(index);
	return result;
}

int RandomBag::size() const { //我们还要记得把const也添加到实现中
	return elems.size();
}
bool RandomBag::isEmpty() const {
	return size() == 0;
}要点总结#
- 在头文件中声明的公共成员变量在
.cpp文件中可自动访问 - 一般要这么设计: 成员变量是私有的,您可以创建公共成员函数来允许用户编辑它们
- 成员函数有一个隐式参数,使它们能够知道它们正在操作哪个对象
- 如果没有构造函数,则会使用一个默认的无参构造函数来实例化所有私有成员变量
- 很快就会看到一个显式构造函数!
17. 动态内存和数组#
上次,我们在vector类型之上实现了RandomBag
但是vector类型本身就是一个抽象(提供的库)——它建立在什么之上呢
该语言提供了哪些基本构建模块,我们如何利用它们来构建我们自己的自定义类?
C++提供的数据存储的基本构建模块有哪些?
获取存储空间
- 向量、栈、队列等都需要存储空间来存放它们所存储的元素
- 该存储空间是通过动态内存分配方式获得的
- 本质上:
- 在运行时,您可以请求额外的存储空间,C++ 会将其分配给您
- 你可以随意使用那个存储空间
- 你必须明确地告诉语言何时停止使用内存
Arrays#
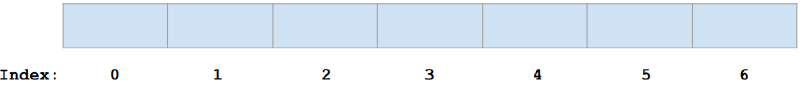
- 计算机上的内存是以称为数组的有序块的形式分配的
- 数组是计算机内存中一块连续的空间,它被分割成多个槽位,每个槽位可以包含一条信息
- 连续是指每个插槽都与其他插槽直接相邻,没有空隙
- 所有数组都有特定的类型,它们的类型决定了每个槽位可以存储什么信息
- 每个槽位都有一个索引,我们可以通过该索引来引用它
动态分配数组#
- 首先,声明一个指向新分配数组的指针,如果数组元素类型为
T,则指针类型为T*- 例如
int*、string*、Vector<double>*
- 例如
- 然后,使用
new关键字创建一个新数组,并将指针指向该数组
T* arr;
arr = new T[size];
//or
T* arr = new T[size];指针#
- 指针是一种数据类型,在处理动态分配内存时尤为重要
- 与其他数据类型一样,指针也会占用内存空间,并且可以存储特定值
- 这些值的含义才是关键,指针总是存储内存地址,就像计算机上某块内存的具体坐标一样
- 因此,它们实际上“指向”了你电脑上的另一个位置
动态分配演示#
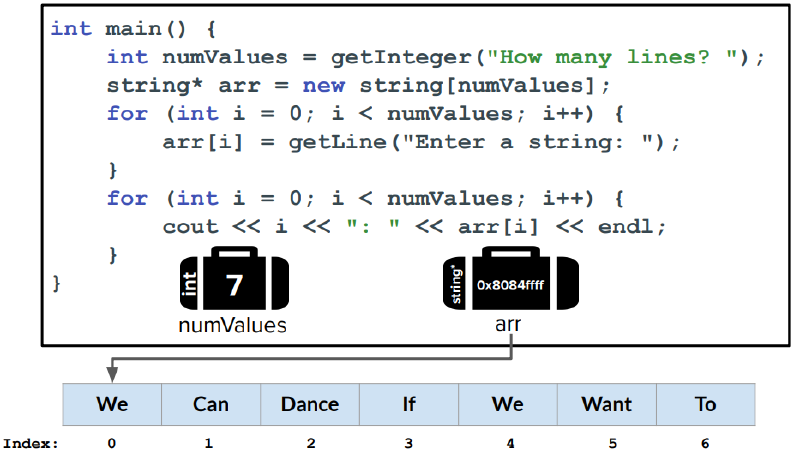
- C++ 的语言理念优先考虑速度而非安全性和简洁性
- 使用
new[]获取的数组是固定大小的:一旦创建,它既不能增长也不能缩小- 程序员版的质量守恒定律
- 使用
new[]获取的数组没有边界检查,如果超出数组的开头或结尾,就会触发未定义行为- 任何事情都可能发生:你读出乱码,你的程序崩溃,你的电脑被黑客控制,或者你上了*《纽约时报》*的头版?
栈内存与堆内存#
| 类型 | 栈上变量(Stack) | 堆上变量(Heap) |
|---|---|---|
| 示例 | vetor<string> varOnStack; | string* arr = new string[numValues]; |
| 内存分配方式 | 静态内存分配 | 动态内存分配 |
| 存储位置 | 变量直接存储在栈内存中 | 程序主动向堆内存申请空间 |
| 访问速度 | 访问速度非常快 | 通常比栈慢一些 |
| 内存管理 | 不需要手动管理,系统会自动释放 | 需要程序员手动管理,使用完成后需要释放 |
| 控制能力 | 对变量生命周期和大小控制较少 | 对变量的生命周期和内存大小有更多控制 |
| 使用注意 | 使用简单,不容易造成内存问题 | 必须正确管理内存,否则可能造成内存泄漏或错误 |
- 声明局部变量或参数时,C++ 会自动处理内存分配和释放
- 内存分配是指计算机将一块内存分配给用户,供用户存储数据的过程
- 内存释放是指将这块内存(数据存储位置)的控制权交还给计算机的过程
- 使用
new时,有责任自己释放分配的内存 - 如果不这样做,就会发生内存泄漏,你的程序将永远无法再次使用那块内存
- 过多的内存泄漏会导致程序崩溃——避免内存泄漏至关重要
- 您可以使用
delete[]运算符释放内存
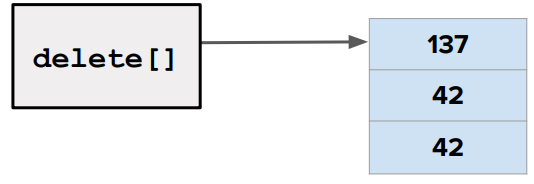
- 这将销毁给定指针指向的数组,而不是指针本身
- 你可以把这个操作理解为把内存控制权交还给计算机
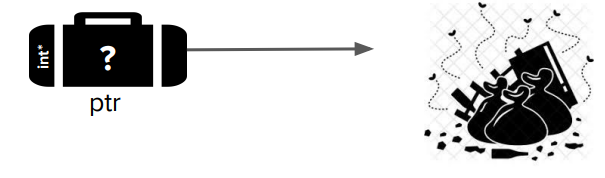
ptr 现在是一个悬空指针。我们可以重新赋值让它指向其他地方,但如果我们尝试从中读取或写入数据,将会发生非常糟糕的事情!
要点
- 您可以使用
new[]在运行时创建固定大小的数组 - C++ 数组不知道自己的长度,也没有边界检查,能力越大,责任越大
- 您有责任通过调用
delete[]来释放您显式分配的任何内存 - 一旦删除了指针指向的内存,就形成了一个悬空指针,不应该再对其进行读写操作
array与vector — —一个常见的错误
- 注意,我们访问array元素的方式与访问vector元素的方式相同,都是使用方括号
- 但是array不是对象,它们没有任何与之关联的函数
- 所以,你不能这样做:
int len = firstTen.length(); // ❌ 没有函数
firstTen.add(42); // ❌ 没有函数
firstTen[10] = 42; // ❌ 缓冲区溢出
总结#
| 类与动态内存的关系 | 我们已经学习了类,类由接口和实现组成 |
| 底层实现需求 | 当我们在最低层抽象中实现类时,需要使用动态内存作为基础工具,以确定程序需要多少内存空间 |
| 动态内存分配 | 使用关键字 new 来申请动态内存 |
| 内存记录方式 | 使用指针来保存和追踪申请到的内存地址(指针将在后续课程中详细学习) |
| 内存释放 | 当动态内存使用完成后,必须使用 delete 释放,否则可能造成内存泄漏 |
| 数组与动态内存 | 目前我们学习了通过数组分配动态内存的方法 |
| 动态数组特点 | 动态数组会提供一块连续的内存空间,并且这块空间只能存储同一种类型的数据,例如 int、string、double 等 |
18. ADT#
Arrays vs. Vectors
- 如果要在程序中以结构化的方式存储信息,数组是必不可少的工具
- 向量是一种很好的抽象概念,它提供了有用的方法和简洁的接口,其他程序员可以利用这些方法和接口来解决有趣的问题
- 想法:让我们使用动态分配的数组作为
vector类的底层数据存储方法,两全其美
OurVector介绍
- 目标:让我们创建我们自己Vector版本
- 范围限制(又名 万事开头难)
- 我们将仅实现斯坦福向量所提供功能的一个子集
OurVector仅存储整数
- 最初,
OurVector只能存储固定数量的元素,但我们会在课程结束时解除这个限制,目前,如果空间不足,我们会抛出一个错误
我们如何设计OurVector
- 成员函数:
OurVector应该支持哪些公共接口?客户端可能想要调用哪些函数 - 成员变量:为了跟踪存储在
OurVector中的数据,我们需要存储哪些私有信息? - 构造函数:当创建
OurVector的新实例时,成员变量是如何初始化的
OurVector 公共接口
class OurVector {
public:
 	OurVector();
 	void add(int value);
	 void insert(int index, int value);
 	int get(int index); //我们将使用 get 方法来模拟 [] 运算符的功能
 	void remove(int index);
	 int size();
	 bool isEmpty();
private:
 /* To be defined soon! */
};
OurVector 成员变量
int* elements;指向整数数组的指针,该数组将作为我们的底层数据存储机制int allocatedCapacity;一个整数,用于存储已分配元素数组的大小,请记住,数组本身并不感知自身大小,因此我们必须手动跟踪它int numItems;一个整数,用于存储向量中当前存储的元素数量
OurVector 头文件
class OurVector {
public:
	 OurVector();
	 ~OurVector();
	 void add(int value);
	 void insert(int index, int value);
	 int get(int index);
	 void remove(int index);
	 int size();
	 bool isEmpty();
private:
	 int* elements;
	 int allocatedCapacity;
	 int numItems;
};
OurVector 构造函数
- 构造函数必须将所有成员变量的值初始化为最初有意义的值
- 应将
allocatedCapacity设置为一个较小的整数 - 应该使用
new[]关键字来分配元素数组 numItems计数器应初始化为0
OurVector 析构函数
- 析构函数是一个特殊的成员函数,负责清理对象的内存
- 对元素数组调用
delete[]运算符,正式将该内存交还给计算机,以避免任何内存泄漏 - 当对象的生命周期结束时(例如,当局部变量超出作用域时),它会自动被调用
- 其他成员变量都是简单的栈分配变量,因此无需进行特殊清理
- 名为 ClassName 的类的析构函数具有
~ClassName()签名
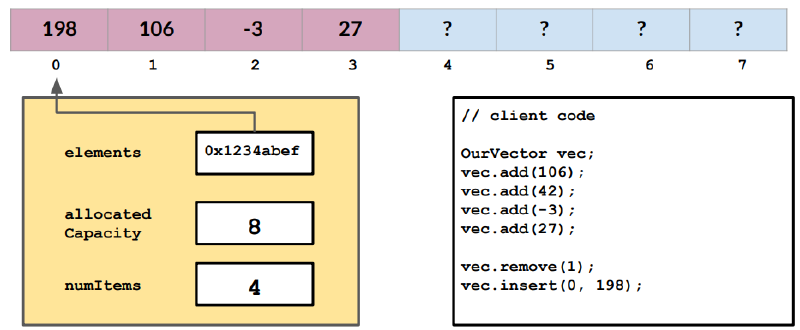
19. 优先级队列和堆#
优先队列#
- 一种根据预设的“优先级”对元素进行排序的队列
- 与普通队列一样,您无法通过索引来获取特定位置的元素
- 它适用于维护按优先级排序的数据
- 急诊室候诊室
- 不同航空公司登机组别(家庭和头等舱乘客、常旅客、A组登机组、B组登机组等)
- 各个数据点可以具有相同的优先级
基本函数
enqueue(priority, elem): 将指定优先级的元素插入队列dequeue(): 从队列中移除优先级最高的元素peek(): 返回队列中优先级最高的元素,但不将其移除size(): 返回队列中元素的数量isEmpty(): 如果队列中没有元素则返回true,否则返回falseclear(): 清空队列
我们如何实现优先级队列?
- 我们希望能够在常数时间内访问优先级最高的元素(即使用
peek()) - 思路:我们可以维护一个排序数组,其中元素按优先级排序(优先级最高的元素位于数组末尾)
- 出队操作很快——只需获取数组中的最后一个元素即可
- 但每次入队时,我们都必须调整整个数组
- 同一个抽象数据类型 (ADT) 可以有多种实现方式
二叉堆#
- 堆是一种基于树的结构,它满足堆的特性,即父节点的优先级高于其任何子节点
- 附加属性
- 二元结构:每个"父母"有两个"孩子”(但"兄弟姐妹"之间没有隐含的顺序)
- 除最底层外其余层级均已填充(每个父母必须有两个孩子),最底层从左到右填充
- 有两种类型 → 我们使用哪种取决于我们如何定义“更高”的优先级
- Min-heap:数字越小,优先级越高(越靠近根节点)
- Max-heap:数字越大,优先级越高(越靠近根节点)
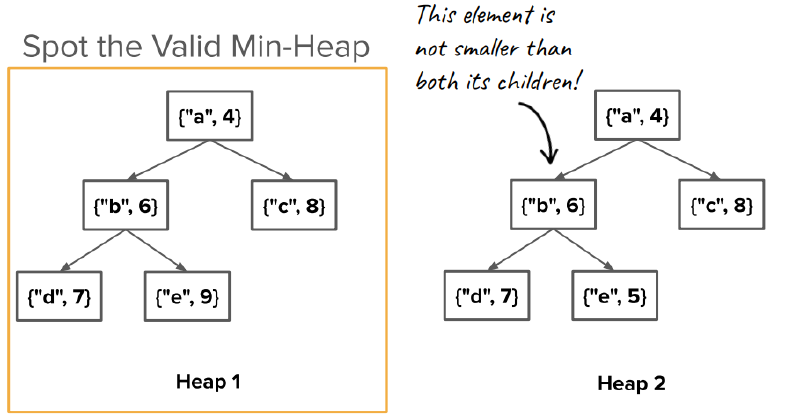
如何实现
- 二叉堆既是实现PriorityQueue的另一种方式,也是对数组的一种抽象
- 稍后我们将看到存储树状结构的不同方法,但对于堆(看起来像树),最好的解决方案实际上是一个简单的数组
- 这是因为该结构完整,从左到右所有楼层都已填满
在数组中,树中的父节点和子节点之间是什么关系?
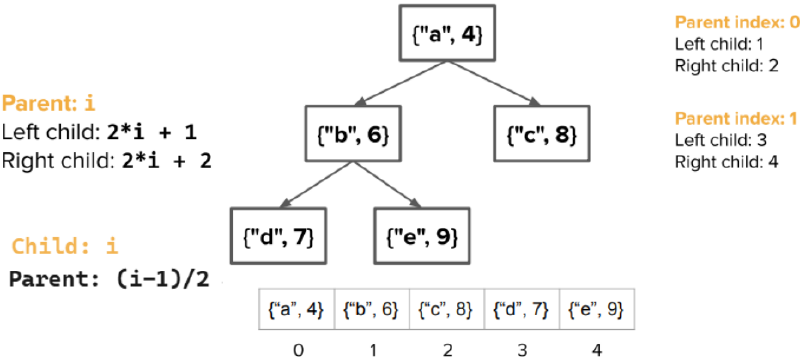
总结#
- 优先队列:一种特殊的队列,其中的元素根据优先级进行排序。
- 出队(Dequeued)时,最高优先级的元素会最先被取出。
- 二叉堆:实现优先队列的一种高效数据结构。
- 最小堆(Min-heap):数值越小,优先级越高
- 最大堆(Max-heap):数值越大,优先级越高
- 底层实现:同一个抽象数据类型可以有不同的底层实现,这的两种优先队列实现方式中,都会使用数组来存储数据
20. 内存与指针#
内存系统#
什么是计算机内存?#
- 计算机是一台真实的物理机器,由许多不同的组件构成。我们统称这些组件为计算机的硬件
- 当我们编写计算机程序(我们称之为软件)时,我们可以向计算机硬件发送特定指令,以进行计算、存储信息等等
- 我们编写的所有程序都使用计算机硬件中的一个特定组件,称为随机存取存储器(RAM)
- 这就是我们通常所说的“计算机内存”
- C++ 为我们提供了多种从代码访问计算机硬件的基本方法
计算机内存是如何组织的?#
- 让我们构建一个关于数据在计算机内存中如何组织的心理模型
- 内存可以被视为一个巨大的盒子(或者为了保持主题一致,也可以说成是行李箱)集合体,我们可以将信息存储在其中
- Q:我们如何与计算机通信,以准确找到我们要访问/存储信息的盒子?
- A:计算机内部的组织系统可以定位每个数据框,其中每个数据框都有一个关联的数字位置,称为内存地,就像普通地址一样,这个值告诉我们盒子位于哪里
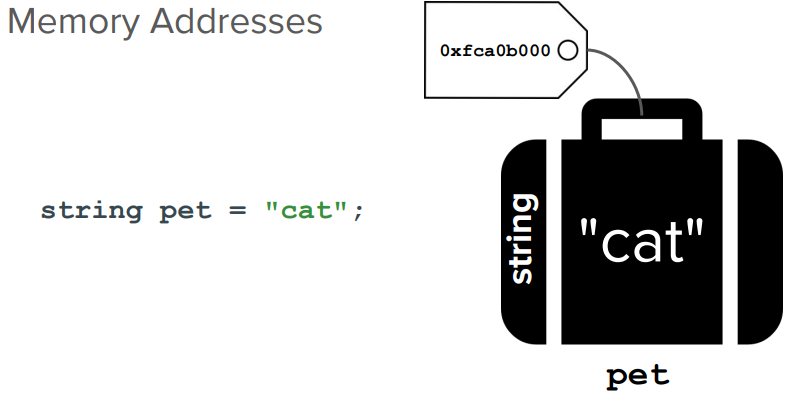
pet的内存地址为0xfca0b000,这个特殊的数值在整个计算机内存池中充当该变量的唯一标识符
这个值是如何确定的?
地址是由计算机(操作系统)确定的,而不是你
那真的是个数字吗?为什么前面是0x,里面还有字母?
我们来(简单地)聊聊**十六进制(Hex)**吧
Hex#
- 通常,我们使用十进制(以10为基数)数字系统来表示数字
- 在计算机系统中,有许多因素使得使用**十六进制(以16为基数)**数字系统来表示数字更加方便
- 每个位值代表 16 的一个因子(\(16^0、16^1、16^2\)等),共有 16 个“数字”
- 由于数字只有 10 个(0-9),因此该系统也使用字母 a 到 f 作为“数字”
- \(0,1...9,a(10),b(11),c(12),d(13),e(14),f(15)\)
- 前缀
0x用于表示该数字以十六进制表示 - 最后,请记住,具体的地址值对我们来说没有任何特殊意义,因为它们始终是由计算机生成的,这只是一个有趣的题外话
总结#
- 内存中的每个位置(因此每个变量)都有一个地址
- 每个地址都对应于内存中的一个唯一位置
- 计算机生成/知道程序中每个变量的地址
- 给定一个内存地址,计算机可以找出该位置存储的值
在 C++ 中,我们如何才能真正使用内存地址来读取和操作计算机内存呢?
答案是:指针
指针#
- 指针是一种新的数据类型,它允许我们直接操作计算机内存地址
- 与其他数据类型一样,指针也会占用内存空间并存储特定值
- 指针始终存储一个内存地址,告诉我们应该在计算机内存的哪个位置查找特定值
- 这样做,它们实际上就“指向”了你电脑上的另一个位置
指针语法#
- 要声明特定类型的指针,请使用
*(星号)符号
string* petPtr; // 一个指向字符串的指针
int* agePtr; // 一个指向整形的指针
char* letterPtr; // 一个指向字符的指针
(注意:重要提示:petPtr的类型是string*,而不是string,指针类型与被指向对象类型不同)
- 初始化指针时,我们可以使用
&(与号)运算符来获取要指向的变量的地址
string pet = "cat";
string* petPointer = &pet;

//not pointer
int a = 1;
int& b = a;(注意:注意:要与int&要区分,符号相同,但含义截然不同!另外,cs106b中几乎不使用指针)
- 指针可以用来存储 new 关键字生成的值(它只是一个内存地址)
- 我们在数组的上下文中对此很熟悉:
int* elements = new int[5];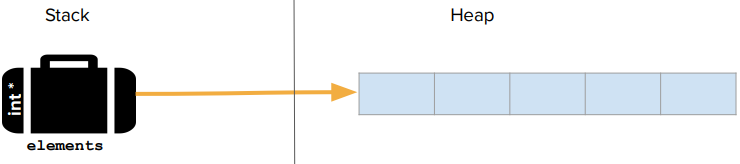
- C++也允许我们动态地为单个变量分配空间
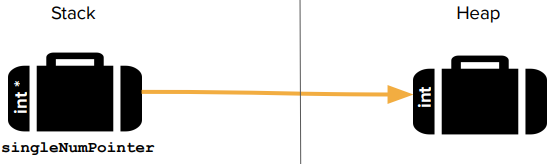
- 要读取或修改指针指向的变量,我们使用
*(星号)运算符来解引用该指针 - 解引用指针是指沿着箭头找到箭头指向的内存位置,然后读取或修改存储在那里的值
string* petPtr; //一个指针
string pet = "cat"; //一个变量
petPtr = &pet; //petPtr为pet的内存地址
cout << *petPtr << endl; // *petPtr为pet所在内存地址的值(也就是pet的值)
*petPtr = "dog"; //可以进行修改
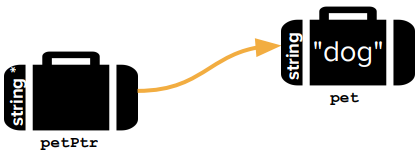
题外话:C++ 的可爱怪癖#
- 如果使用
new[]运算符分配内存(例如new int[137),则必须使用delete[]运算符释放它 - 如果使用
new运算符(例如new int)分配内存,则必须使用delete运算符释放它 - 请务必使用正确的删除操作。混淆这些操作会导致糟糕的、未定义的行为!
小细节#
- 使用指针和直接内存访问可能非常棘手!
- 在尝试解引用指针之前,必须始终高度警惕指针的指向以及指针的有效性
- 以下是一些使用指针时需要牢记的实用技巧: 如果我们想要声明/初始化一个指针变量,但我们还没有任何东西可以指向它,该怎么办?
string* petPtr;
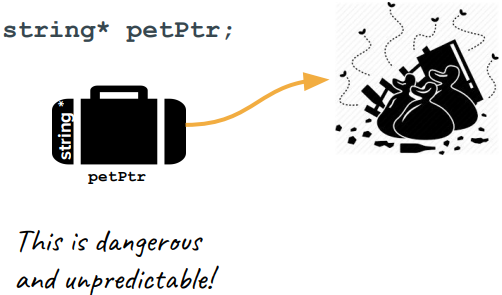
为了确保我们能够判断指针是否具有有效地址,请将声明的指针设置为特殊值nullptr,表示“无有效地址”。
string* petPtr = nullptr;
如何判断一个指针是否可以安全使用(解引用)?
如果您不确定指针是否保存了有效地址,则应检查是否为 nullptr!
void printPetName(string* petPtr) {
 	if (petPtr != nullptr) { //如果它不是 nullptr
 	cout << *petPtr << endl; //打印出 petPtr 指向的值
	 } else {                //否则打印错误信息
	 cout << "petPtr is not valid!" << endl;
	 }
}
(注意:不要解引用一个空指针时,你会遇到段错误,程序会崩溃!)
21. 链表#
什么是链表#
- 链表是由一系列节点组成的链条
- 每个节点包含两条信息:
- 存储在序列中的一些数据
- 指向链表中下一个节点的链接
- 我们可以从第一个节点开始,沿着它的链接重复遍历链表
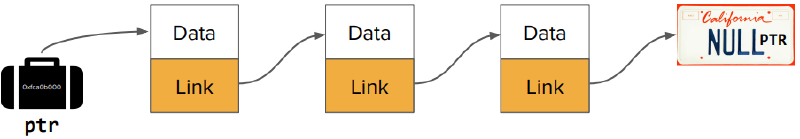
好处
- 比数组更灵活
- 由于它们不是连续的,因此更容易重新排列
- 我们可以高效地将新元素插入列表,或从列表中的任何位置删除现有元素
- 我们永远不需要进行大规模的复制操作
- 链表有很多优缺点,通常不是最佳的数据结构
Node结构
struct Node
{
	string data;
	Node* next;
}- 该结构体是递归定义的!(节点和链表本身都是递归定义的)
- 编译器可以处理节点定义中存在
Node*的情况,因为它知道它只是一个指针- (不可能在结构体内部递归地定义一个实际的节点对象)
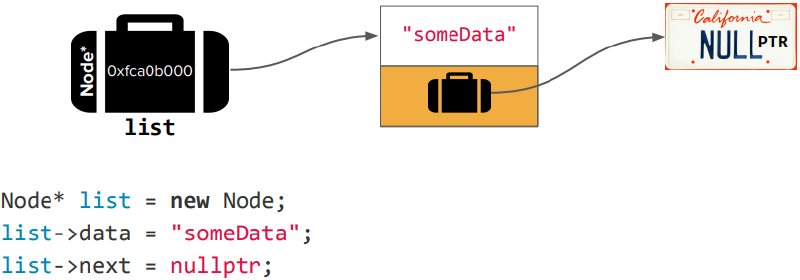
(箭头符号->用于解引用 AND 操作,它专门用于访问指向结构体的指针的字段)
操作链表#
常见的链表操作
- 遍历
- 重新配线
- 插入
- 删除
实现栈
栈即链表
- 我们将维护一个指向栈顶元素的指针
Node* top- 当栈为空时,该成员变量将被初始化为
nullptr
- 当栈为空时,该成员变量将被初始化为
- 我们的链表节点将从栈顶连接到栈底
- 我们的栈专门用于存储整数,因此我们的
Node结构体的数据字段也将是int类型:
struct Node
{
	int data;
	Node* next;
}
push()
- 假设我们有如下栈,想要将数据压入其中:
Stack myStack = {9, 8}; //8位于堆栈的“顶部”
myStack.push(7); //我们希望结果为 {9, 8, 7}
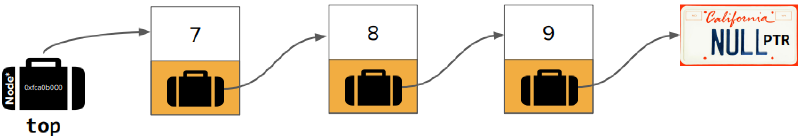
错误地释放链表
void freeList(Node* list) {
 /* ❌❌❌❌❌❌❌❌❌❌❌ */
 	while (list != nullptr) {
 		delete list;
 		list = list->next;
 	}
 }
正确地释放链表
void freeList(Node* list) {
 	while (list != nullptr) {
 		Node* next = list->next;
 		delete list;
 		list = next;
 	}
 }
带尾指针的列表
Node* createListWithTailPtr(Vector<string> values) {
 	if (values.isEmpty()) return nullptr;
 	Node* head = new Node(values[0], nullptr);

 	Node* cur = head;
	 for (int i = 1; i < values.size(); i++) {
		 Node* newNode = new Node(values[i], nullptr);
		 cur->next = newNode;
 		cur = newNode;
 	}
 	return head;
}Reply by EmailNOT END